
Bezpłatny fragment - Dariusz Piotrowski — Artificial Intelligence
Od podstaw informatyki do inteligentnych technologii przyszłości
Książka o rozwoju informatyki, sztucznej inteligencji i rzeczywistości wirtualnej. O tym, jak działają nowoczesne technologie, jak zmieniają nasz świat i jakie możliwości otwierają przed człowiekiem.
Prawa autorskie
Copyright © 2026. Wszelkie prawa zastrzeżone.
Niniejsza publikacja jest chroniona prawem autorskim. Żadna jej część nie może być kopiowana, rozpowszechniana ani wykorzystywana w celach komercyjnych bez zgody autora, z wyjątkiem przypadków dozwolonych przez obowiązujące przepisy prawa.
Charakter publikacji
Książka ma charakter edukacyjny i informacyjny. Jej celem jest przybliżenie zagadnień związanych z informatyką, sztuczną inteligencją oraz rzeczywistością wirtualną.
Technologie opisane w książce rozwijają się dynamicznie, dlatego niektóre informacje mogą z czasem wymagać aktualizacji.
Odpowiedzialność za wykorzystanie informacji
Przykłady, instrukcje i fragmenty kodu zamieszczone w publikacji służą celom edukacyjnym. Przed zastosowaniem ich w praktyce należy sprawdzić ich poprawność, bezpieczeństwo i zgodność z aktualną dokumentacją techniczną.
WSTĘP
Świat, który zmienia technologia
Żyjemy w czasach, w których technologia rozwija się szybciej niż kiedykolwiek wcześniej. Komputery, internet, urządzenia mobilne i systemy informatyczne stały się nieodłączną częścią naszego codziennego życia. Korzystamy z nich w pracy, podczas nauki, w komunikacji z innymi ludźmi oraz w czasie wolnym.
Jeszcze kilkadziesiąt lat temu wiele rozwiązań, które dziś uznajemy za oczywiste, wydawało się odległą wizją przyszłości. Obecnie możemy rozmawiać z systemami sztucznej inteligencji, generować obrazy i teksty za pomocą kilku poleceń, automatyzować zadania oraz poznawać cyfrowe światy dzięki technologii rzeczywistości wirtualnej.
Te zmiany pokazują, że informatyka nie jest już wyłącznie dziedziną zajmującą się komputerami. Stała się fundamentem współczesnej cywilizacji i jednym z najważniejszych czynników wpływających na rozwój gospodarki, nauki, edukacji oraz kultury.
Dlaczego IT, AI i VR?
Tematem tej książki są trzy obszary, które coraz częściej się ze sobą łączą: informatyka, sztuczna inteligencja i rzeczywistość wirtualna.
IT, czyli technologie informatyczne, stanowią podstawę świata cyfrowego. Dzięki nim możemy przechowywać dane, tworzyć programy, komunikować się przez internet i budować systemy wykorzystywane przez ludzi oraz przedsiębiorstwa.
AI, czyli sztuczna inteligencja, pozwala tworzyć systemy zdolne do wykonywania zadań wymagających między innymi analizy danych, rozpoznawania obrazów, przetwarzania języka czy generowania nowych treści. Nie oznacza to jednak, że każdy system AI myśli i rozumie świat tak jak człowiek. Sposób działania sztucznej inteligencji zależy od zastosowanych modeli, danych i metod uczenia.
VR, czyli rzeczywistość wirtualna, umożliwia wejście do cyfrowego środowiska, w którym użytkownik może rozglądać się, poruszać i wchodzić w interakcje z wirtualnymi obiektami. Technologia ta znajduje zastosowanie w grach, edukacji, szkoleniach, projektowaniu oraz medycynie.
Największe możliwości pojawiają się wtedy, gdy te trzy dziedziny współpracują. Sztuczna inteligencja może sterować wirtualnymi postaciami, dostosowywać środowisko do zachowania użytkownika i pomagać w tworzeniu nowych światów. Informatyka zapewnia natomiast sprzęt, oprogramowanie i infrastrukturę niezbędną do działania takich rozwiązań.
Moja droga do nowych technologii
Moje zainteresowanie informatyką i sztuczną inteligencją jest częścią mojej osobistej drogi. Od najmłodszych lat zdobywałem doświadczenia, które kształtowały moje podejście do nauki, pracy i rozwoju.
Ważnym etapem mojego życia był sport. Przez osiem lat grałem w hokeja na lodzie jako bramkarz w MOSiR Tychy. Sport nauczył mnie systematyczności, odpowiedzialności i wytrwałości. Są to cechy przydatne również w świecie technologii, w którym osiągnięcie dobrych rezultatów wymaga cierpliwości, ćwiczeń i gotowości do uczenia się na błędach.
Później rozwijałem swoją wiedzę w obszarze zarządzania informacją i informatyki. Z czasem coraz większą uwagę zacząłem poświęcać sztucznej inteligencji. To zainteresowanie stało się dla mnie sposobem spędzania wolnego czasu, poznawania nowych rozwiązań i odkrywania możliwości, jakie otwiera współczesna technologia.
W tej książce chcę połączyć wiedzę techniczną z praktycznym spojrzeniem na rozwój cyfrowego świata. Nie chodzi wyłącznie o poznanie definicji, lecz także o zrozumienie, jak poszczególne elementy współczesnej technologii działają i w jaki sposób można je wykorzystać.
Dla kogo jest ta książka?
Publikacja została pomyślana jako przewodnik dla osób, które chcą lepiej zrozumieć informatykę, sztuczną inteligencję i rzeczywistość wirtualną.
Może być przydatna dla:
— osób rozpoczynających naukę informatyki;
— uczniów i osób rozwijających kompetencje cyfrowe;
— czytelników zainteresowanych działaniem sztucznej inteligencji;
— osób chcących poznać podstawy programowania i tworzenia aplikacji;
— entuzjastów gier komputerowych oraz rzeczywistości wirtualnej;
— osób poszukujących pomysłów na własne projekty technologiczne.
Nie musisz być programistą ani specjalistą od zaawansowanych systemów komputerowych, aby rozpocząć lekturę. W kolejnych rozdziałach będziemy stopniowo przechodzić od podstaw informatyki do bardziej zaawansowanych zagadnień związanych z uczeniem maszynowym, modelami językowymi, agentami AI i technologiami VR.
Tam, gdzie będzie to pomocne, pojawią się przykłady, objaśnienia pojęć i propozycje ćwiczeń. Ich celem będzie ułatwienie samodzielnego eksperymentowania oraz rozwijania własnych umiejętności.
Jak korzystać z tej książki?
Najlepiej czytać ją w kolejności, w której zostały przedstawione rozdziały. Pierwsze części wyjaśniają podstawowe pojęcia informatyczne, a następne pokazują, jak na tych fundamentach rozwijają się współczesne systemy sztucznej inteligencji i środowiska wirtualne.
Jeśli niektóre zagadnienia będą już Ci znane, możesz przejść do kolejnych tematów. Warto jednak wracać do definicji i przykładów, gdy pojawią się bardziej złożone koncepcje.
Pamiętaj również, że technologie zmieniają się bardzo szybko. Narzędzia, modele i rozwiązania omawiane w książce mogą być rozwijane lub zastępowane nowymi wersjami. Dlatego równie ważne jak zapamiętywanie informacji jest zdobycie umiejętności samodzielnego poszukiwania wiedzy, oceniania źródeł i bezpiecznego korzystania z technologii.
Technologia jako narzędzie człowieka
Sztuczna inteligencja, informatyka i rzeczywistość wirtualna oferują wiele możliwości, ale wymagają także odpowiedzialności. Systemy cyfrowe mogą wspierać naukę, pracę i kreatywność, jednak ich wyniki trzeba oceniać krytycznie. Ważne są również prywatność, bezpieczeństwo danych, prawa autorskie i wpływ nowych rozwiązań na społeczeństwo.
Technologia sama w sobie nie gwarantuje postępu. Jej znaczenie zależy od tego, w jaki sposób ją projektujemy, rozwijamy i wykorzystujemy.
Mam nadzieję, że ta książka pomoże Ci spojrzeć na świat cyfrowy z większym zrozumieniem, rozbudzi ciekawość i zachęci do samodzielnego odkrywania nowych możliwości.
Przed nami podróż od podstaw działania komputerów, przez rozwój sztucznej inteligencji, aż po inteligentne środowiska wirtualne. To podróż, w której wiedza teoretyczna będzie łączyć się z praktyką, a współczesne rozwiązania staną się punktem wyjścia do poznawania technologii przyszłości.
Zapraszam do lektury.
Dariusz Piotrowski — Sztuczna Inteligencja
Rozdział 1. Moja droga do sztucznej inteligencji
1.1. Początek mojej historii
Każdy człowiek ma swoją historię. Składają się na nią doświadczenia, decyzje, zainteresowania oraz wydarzenia, które stopniowo kształtują jego sposób patrzenia na świat. Moja droga do poznania sztucznej inteligencji rozpoczęła się wiele lat temu i jest związana zarówno z moją edukacją, jak i zainteresowaniami technologicznymi.
Nazywam się Dariusz Piotrowski. W swoim życiu miałem okazję poznać różne dziedziny, które nauczyły mnie systematyczności, odpowiedzialności i samodzielnego zdobywania wiedzy. Jednym z ważnych etapów mojej młodości był sport, a szczególnie hokej na lodzie. Później istotne miejsce w moim życiu zajęła informatyka, która otworzyła przede mną nowe możliwości poznawania technologii.
Dziś szczególnie interesuje mnie sztuczna inteligencja. Od kiedy poznałem tę dziedzinę, poświęcam jej swój wolny czas, starając się lepiej zrozumieć jej możliwości, sposób działania oraz znaczenie dla przyszłości człowieka.
Ta książka jest kolejnym krokiem na mojej drodze poznawania tej fascynującej technologii.
1.2. Hokej na lodzie — szkoła charakteru
W wieku od dziesięciu do osiemnastu lat grałem w hokeja na lodzie jako bramkarz w klubie MOSiR Tychy.
Hokej to sport wymagający refleksu, koncentracji, dyscypliny i odporności psychicznej. Bramkarz zajmuje szczególną pozycję w drużynie. Musi obserwować sytuację na lodzie, przewidywać rozwój akcji i reagować w ułamku sekundy. Czasami o wyniku decyduje jedna interwencja.
Osiem lat spędzonych na uprawianiu tego sportu stanowiło ważną część mojej młodości. Był to czas nauki, treningów i zdobywania doświadczeń, które wykraczały poza samą grę.
Sport uczy, że osiągnięcie celu wymaga zaangażowania i regularnej pracy. Pokazuje również, że niepowodzenia są naturalną częścią rozwoju. Ważne jest to, aby wyciągać z nich wnioski i podejmować kolejne próby.
Choć hokej i sztuczna inteligencja należą do zupełnie różnych dziedzin, można dostrzec między nimi pewne podobieństwa. W obu przypadkach istotne są obserwacja, analiza sytuacji, przewidywanie oraz podejmowanie decyzji na podstawie dostępnych informacji.
Moje doświadczenia sportowe stanowią część historii, która doprowadziła mnie do miejsca, w którym jestem dzisiaj.
1.3. Edukacja i pierwsze kroki w informatyce
Równolegle z rozwojem sportowym zdobywałem wykształcenie.
Ukończyłem gimnazjum sportowe, a następnie liceum profilowane o kierunku zarządzanie informacją. Był to etap, w którym rozwijałem swoją wiedzę i przygotowywałem się do kolejnych decyzji dotyczących przyszłości.
Później kontynuowałem naukę w szkole policealnej na kierunku technik informatyk, ucząc się w trybie zaocznym lub wieczorowym.
Informatyka pozwala spojrzeć na świat z innej perspektywy. Za programami komputerowymi, aplikacjami i urządzeniami, z których korzystamy na co dzień, kryją się określone zasady działania, algorytmy oraz rozwiązania opracowane przez ludzi.
Zrozumienie tych mechanizmów wymaga czasu i systematycznej nauki. Każda nowa informacja może prowadzić do kolejnych pytań, a odpowiedzi często otwierają drogę do jeszcze głębszego poznania danego zagadnienia.
Moja edukacja informatyczna stała się ważnym elementem przygotowania do poznawania nowoczesnych technologii, w tym sztucznej inteligencji.
1.4. Praca i codzienne życie
Po zakończeniu kolejnych etapów edukacji rozpocząłem pracę zawodową. Pracuję do dziś, łącząc codzienne obowiązki z własnymi zainteresowaniami.
Życie nie składa się wyłącznie z nauki i realizowania pasji. Każdy człowiek musi znaleźć równowagę pomiędzy pracą, obowiązkami i czasem przeznaczonym dla siebie.
W moim przypadku ważnym obszarem, któremu poświęcam wolny czas, jest sztuczna inteligencja.
Rozwój technologii sprawia, że nie trzeba ograniczać się wyłącznie do wiedzy zdobywanej w szkole. Można samodzielnie poznawać nowe zagadnienia, zadawać pytania, analizować informacje i stopniowo poszerzać swoje horyzonty.
Właśnie ta możliwość samodzielnego odkrywania nowych rzeczy jest dla mnie szczególnie interesująca.
1.5. Rodzina i doświadczenia życiowe
Ważną częścią mojego życia są również doświadczenia rodzinne.
Mój brat wyjechał za granicę, kiedy miałem siedemnaście lat. Niedawno mój ojciec wrócił do Polski. Są to wydarzenia z mojej osobistej historii, które stanowią część drogi, jaką przeszedłem.
Życie każdego człowieka składa się z wielu etapów. Niektóre wiążą się z nauką, inne z pracą, zmianami w rodzinie czy poszukiwaniem własnego miejsca w świecie.
Nie wszystkie doświadczenia da się łatwo opisać w kilku zdaniach. Czasami dopiero z perspektywy czasu można lepiej zrozumieć, jak poszczególne wydarzenia wpłynęły na nasze zainteresowania, sposób myślenia i podejmowane decyzje.
W mojej książce chcę przedstawić przede wszystkim drogę, która doprowadziła mnie do zainteresowania sztuczną inteligencją. To właśnie ta technologia stała się jednym z najważniejszych obszarów, którym poświęcam swój wolny czas.
1.6. Moje pierwsze spotkanie ze sztuczną inteligencją
Sztuczną inteligencję poznałem, kiedy miałem siedemnaście lat.
Od tamtej pory technologia ta pozostaje w kręgu moich zainteresowań. Do dziś poświęcam jej swój wolny czas, poznając jej możliwości i obserwując, jak zmienia się wraz z rozwojem informatyki.
Sztuczna inteligencja przyciąga uwagę tym, że pozwala komputerom wykonywać zadania, które jeszcze niedawno kojarzyły się przede wszystkim z ludzkimi zdolnościami poznawczymi. Należą do nich między innymi analiza języka, rozpoznawanie wzorców, tworzenie treści oraz wspomaganie rozwiązywania problemów.
Z biegiem czasu rozwój tej dziedziny stał się coraz bardziej widoczny. Nowoczesne systemy potrafią prowadzić rozmowy, pomagać w nauce, wspierać programowanie i przetwarzać duże ilości informacji.
Jednak dla mnie istotne jest nie tylko to, co sztuczna inteligencja potrafi zrobić. Równie ważne są pytania o to, jak działa, na jakich zasadach się opiera i jakie ma ograniczenia.
To właśnie chęć lepszego poznania tej technologii sprawia, że nadal poświęcam jej uwagę.
1.7. Dlaczego postanowiłem napisać tę książkę?
Pisanie książki o sztucznej inteligencji jest dla mnie sposobem na uporządkowanie wiedzy i przedstawienie tej dziedziny innym ludziom.
Sztuczna inteligencja rozwija się szybko, a liczba informacji na jej temat stale rośnie. Jednocześnie wiele osób spotyka się z trudnymi pojęciami, specjalistyczną terminologią i opisami technicznymi, które mogą być niezrozumiałe dla początkujących.
Chciałbym, aby ta książka pomogła czytelnikom stopniowo poznawać świat AI.
Nie zamierzam ograniczać się do przedstawiania samych definicji. Chcę również wyjaśnić, jak poszczególne rozwiązania działają, jakie technologie stoją za współczesnymi systemami i w jaki sposób można wykorzystać tę wiedzę w praktyce.
Dlatego w kolejnych rozdziałach pojawią się zagadnienia związane z programowaniem, uczeniem maszynowym, sieciami neuronowymi, modelami językowymi oraz zastosowaniami sztucznej inteligencji w codziennym życiu i pracy.
Chciałbym, aby książka była przystępna dla osób, które dopiero zaczynają poznawać tę tematykę, a jednocześnie zawierała informacje przydatne dla czytelników zainteresowanych techniczną stroną AI.
1.8. Moje podejście do sztucznej inteligencji
Uważam, że poznawanie nowych technologii wymaga przede wszystkim ciekawości i otwartości na zdobywanie wiedzy.
Sztuczna inteligencja daje wiele możliwości, ale nie należy traktować jej jako rozwiązania wszystkich problemów. To narzędzie, którego skuteczność zależy od zastosowanych metod, jakości danych i sposobu wykorzystania.
Ważne jest, aby zadawać pytania, sprawdzać uzyskiwane informacje i rozumieć ograniczenia technologii.
Szczególnie interesujące jest dla mnie to, że sztuczna inteligencja łączy wiele dziedzin wiedzy. Informatyka, matematyka, analiza danych i język naturalny współpracują ze sobą, tworząc systemy zdolne do wykonywania coraz bardziej złożonych zadań.
Zrozumienie tych zależności pozwala lepiej ocenić zarówno możliwości AI, jak i wyzwania związane z jej rozwojem.
Mam nadzieję, że ta książka pomoże czytelnikom spojrzeć na sztuczną inteligencję nie tylko jak na nowoczesną technologię, ale również jak na dziedzinę, którą można poznawać, analizować i rozwijać.
1.9. Początek dalszej drogi
Moja historia obejmuje różne doświadczenia: sport, edukację, pracę i wieloletnie zainteresowanie nowoczesnymi technologiami.
Każdy z tych etapów stanowi część mojej drogi do miejsca, w którym jestem obecnie. Szczególne znaczenie ma dla mnie sztuczna inteligencja, którą poznałem w wieku siedemnastu lat i której nadal poświęcam swój wolny czas.
Ta książka jest okazją, aby rozpocząć uporządkowaną podróż przez świat AI.
W kolejnych rozdziałach pozostawimy moją osobistą historię na dalszym planie i skupimy się już na samej sztucznej inteligencji. Przyjrzymy się jej podstawom, historii, metodom działania, narzędziom programistycznym oraz praktycznym zastosowaniom.
Zaczniemy od fundamentów, aby następnie przejść do coraz bardziej zaawansowanych zagadnień.
Na początek postawimy sobie najważniejsze pytanie:
Czym właściwie jest sztuczna inteligencja i w jaki sposób komputer może wykonywać zadania wymagające analizy, uczenia się i przetwarzania informacji?
Odpowiedź na to pytanie rozpocznie naszą dalszą podróż przez świat sztucznej inteligencji.
ROZDZIAŁ 2
IT — FUNDAMENTY ŚWIATA CYFROWEGO
2.1. Czym jest IT?
Żyjemy w czasach, w których technologia informacyjna stała się jednym z najważniejszych elementów współczesnego świata. Korzystamy z niej niemal każdego dnia, często nawet nie zastanawiając się, jak wiele procesów zachodzi w tle.
Kiedy wysyłamy wiadomość, robimy przelew bankowy, oglądamy film przez internet albo korzystamy z aplikacji w telefonie, używamy rozwiązań należących do obszaru IT.
Skrót IT pochodzi od angielskiego określenia Information Technology, czyli technologii informacyjnej. Obejmuje ono technologie, systemy i narzędzia służące do gromadzenia, przetwarzania, przechowywania, przesyłania oraz ochrony informacji.
IT nie ogranicza się wyłącznie do komputerów. To rozbudowany obszar, w którym spotykają się sprzęt elektroniczny, oprogramowanie, sieci komputerowe, bazy danych, cyberbezpieczeństwo, chmura obliczeniowa oraz wiele innych dziedzin.
Współczesne IT stanowi podstawę działania banków, sklepów internetowych, szpitali, szkół, zakładów produkcyjnych i urzędów. Bez systemów informatycznych wiele procesów, które obecnie wykonujemy w ciągu kilku sekund, wymagałoby znacznie więcej czasu i pracy.
Warto również zauważyć, że technologia informacyjna nie jest już wyłącznie narzędziem wspomagającym człowieka. Coraz częściej staje się środowiskiem, w którym pracujemy, komunikujemy się, uczymy i tworzymy nowe rozwiązania.
Rozwój sztucznej inteligencji oraz rzeczywistości wirtualnej pokazuje, że możliwości IT stale się rozszerzają. Aby zrozumieć te nowoczesne technologie, najpierw należy poznać podstawy świata informatyki.
2.2. Najważniejsze obszary IT
Technologia informacyjna składa się z wielu dziedzin. Niektóre są ze sobą ściśle powiązane, inne wymagają specjalistycznej wiedzy i odrębnych narzędzi.
2.2.1. Sprzęt komputerowy
Sprzęt komputerowy, określany również jako hardware, obejmuje fizyczne elementy systemów informatycznych.
Należą do nich między innymi procesory, pamięć RAM, dyski, płyty główne, karty graficzne, monitory, klawiatury i urządzenia sieciowe.
Sprzęt stanowi fizyczną podstawę działania komputera. Sam w sobie nie wystarcza jednak do wykonywania większości zadań użytkownika. Potrzebuje oprogramowania, które określa, jakie operacje mają być realizowane.
Wybór odpowiedniego sprzętu zależy od przeznaczenia urządzenia. Komputer do pracy biurowej może mieć inne wymagania niż stacja robocza wykorzystywana do projektowania 3D, montażu filmów lub uruchamiania lokalnych modeli sztucznej inteligencji.
2.2.2. Oprogramowanie
Oprogramowanie, czyli software, to programy i instrukcje, które pozwalają komputerowi wykonywać określone zadania.
Możemy wyróżnić między innymi systemy operacyjne, aplikacje użytkowe, narzędzia programistyczne oraz oprogramowanie serwerowe.
System operacyjny zarządza zasobami komputera i umożliwia uruchamianie innych programów. Aplikacje służą natomiast do realizacji konkretnych zadań, takich jak edycja dokumentów, obróbka zdjęć, komunikacja czy analiza danych.
Oprogramowanie jest niezbędne, aby wykorzystać możliwości sprzętu. Nawet bardzo wydajny komputer ma ograniczoną użyteczność, jeśli nie dysponuje odpowiednimi programami.
2.2.3. Sieci komputerowe
Sieci komputerowe umożliwiają wymianę informacji między urządzeniami.
Mogą obejmować kilka komputerów połączonych w jednym budynku, sieć firmową rozciągającą się na wiele lokalizacji albo rozległą infrastrukturę łączącą urządzenia na całym świecie.
Najbardziej znanym przykładem globalnej sieci jest internet. Dzięki niemu możemy korzystać ze stron internetowych, poczty elektronicznej, komunikatorów, usług bankowych i wielu innych rozwiązań.
Sieci komputerowe są również podstawą działania systemów chmurowych, zdalnej pracy, usług streamingowych i wielu aplikacji wykorzystujących sztuczną inteligencję.
2.2.4. Bazy danych
Bazy danych służą do uporządkowanego przechowywania informacji.
Wykorzystują je między innymi sklepy internetowe, banki, placówki medyczne, systemy rezerwacji, platformy społecznościowe i aplikacje biznesowe.
Przykładowo sklep internetowy może przechowywać informacje o produktach, cenach, klientach, zamówieniach i stanach magazynowych. Odpowiednio zaprojektowana baza danych pozwala szybko wyszukiwać potrzebne informacje oraz aktualizować je w kontrolowany sposób.
Bazy danych odgrywają także istotną rolę w rozwoju sztucznej inteligencji. Dane wykorzystywane do analizy, trenowania modeli i generowania raportów muszą być przechowywane oraz przetwarzane w sposób dostosowany do konkretnego zastosowania.
2.2.5. Cyberbezpieczeństwo
Wraz z rozwojem technologii rośnie znaczenie ochrony informacji.
Cyberbezpieczeństwo obejmuje działania, które mają chronić systemy, urządzenia, sieci i dane przed nieautoryzowanym dostępem, kradzieżą, uszkodzeniem lub zakłóceniem działania.
Zagrożenia mogą przyjmować różne formy. Należą do nich złośliwe oprogramowanie, próby wyłudzenia danych, ataki na serwery, kradzież haseł oraz wykorzystywanie błędów w oprogramowaniu.
Podstawowe zasady bezpieczeństwa obejmują stosowanie unikalnych haseł, korzystanie z uwierzytelniania wieloskładnikowego, aktualizowanie oprogramowania i regularne wykonywanie kopii zapasowych.
Bezpieczeństwo nie jest dodatkiem do IT. Stanowi jeden z fundamentów prawidłowego funkcjonowania współczesnych systemów informatycznych.
2.2.6. Chmura obliczeniowa
Chmura obliczeniowa umożliwia korzystanie przez internet z zasobów informatycznych, takich jak przestrzeń dyskowa, serwery, bazy danych i moc obliczeniowa.
Zamiast samodzielnie kupować oraz utrzymywać cały sprzęt, organizacja może wynajmować potrzebne zasoby od dostawcy usług chmurowych.
Takie podejście pozwala elastycznie zwiększać lub zmniejszać wykorzystywane zasoby w zależności od zapotrzebowania.
Z chmury korzystają zarówno duże przedsiębiorstwa, jak i osoby prywatne. Przykładami zastosowań są przechowywanie plików, współpraca nad dokumentami, udostępnianie aplikacji oraz uruchamianie systemów wymagających znacznej mocy obliczeniowej.
Chmura ma szczególne znaczenie dla współczesnej sztucznej inteligencji. Umożliwia korzystanie z rozbudowanych modeli bez konieczności posiadania bardzo wydajnego komputera we własnym domu.
2.2.7. Sztuczna inteligencja jako rozwijający się obszar IT
Sztuczna inteligencja, określana skrótem AI od angielskiego Artificial Intelligence, jest jedną z najszybciej rozwijających się dziedzin technologii.
Obejmuje metody i systemy, które wykonują zadania wymagające określonych zdolności poznawczych, takich jak rozpoznawanie obrazów, analiza języka, przewidywanie wyników czy generowanie treści.
Współczesne rozwiązania AI mogą analizować duże zbiory danych, rozpoznawać wzorce, pomagać w programowaniu, tworzyć teksty i obrazy oraz wspierać procesy decyzyjne.
Nie oznacza to jednak, że każdy system AI rozumie świat w taki sam sposób jak człowiek. Możliwości systemu zależą od jego konstrukcji, danych, sposobu trenowania i warunków wykorzystania.
Sztuczna inteligencja nie funkcjonuje w oderwaniu od pozostałych obszarów IT. Potrzebuje sprzętu, oprogramowania, danych, sieci i odpowiednich zabezpieczeń.
2.3. Jak działa współczesny system informatyczny?
System informatyczny to nie tylko pojedynczy komputer. Zazwyczaj jest to połączenie sprzętu, oprogramowania, danych, procedur i użytkowników, którzy wspólnie realizują określone zadania.
Dobrym przykładem jest bankowość internetowa.
Kiedy klient loguje się do banku, jego urządzenie komunikuje się z systemami bankowymi za pośrednictwem sieci. Serwer otrzymuje żądanie, sprawdza odpowiednie informacje, stosuje zasady bezpieczeństwa i przekazuje wynik do aplikacji użytkownika.
W tym procesie uczestniczy wiele elementów:
— Urządzenie klienta, na przykład komputer lub smartfon.
— Aplikacja lub przeglądarka internetowa.
— Sieć umożliwiająca przesyłanie danych.
— Serwery obsługujące żądania.
— Bazy danych przechowujące niezbędne informacje.
— Mechanizmy bezpieczeństwa kontrolujące dostęp.
— Oprogramowanie odpowiedzialne za logikę działania usługi.
Wszystkie te elementy muszą współpracować. Awaria jednego z nich może spowodować, że usługa przestanie działać prawidłowo.
Podobny schemat występuje w sklepach internetowych, systemach rezerwacji, platformach edukacyjnych i wielu aplikacjach biznesowych.
Warto zatem pamiętać, że nowoczesna technologia jest zwykle wynikiem współpracy wielu komponentów, a nie działania jednego urządzenia.
2.4. Sprzęt komputerowy i jego znaczenie
Sprzęt komputerowy stanowi fizyczną podstawę systemu informatycznego. To dzięki niemu możliwe jest wykonywanie obliczeń, przechowywanie danych, wyświetlanie obrazu i komunikacja z innymi urządzeniami.
Wśród najważniejszych podzespołów znajdują się procesor, pamięć RAM, dysk, płyta główna i układ graficzny.
Każdy z nich pełni inną funkcję. Procesor wykonuje instrukcje, pamięć RAM przechowuje dane potrzebne podczas bieżącej pracy, a dysk służy do długotrwałego przechowywania plików.
Karta graficzna odpowiada za generowanie obrazu i może przyspieszać określone obliczenia. Jest to szczególnie istotne w grach, projektowaniu 3D, rzeczywistości wirtualnej i wybranych zastosowaniach sztucznej inteligencji.
Nie każdy komputer musi jednak być bardzo wydajny. Sprzęt należy dobierać do konkretnych potrzeb.
Do podstawowych zadań biurowych często wystarcza komputer o umiarkowanej wydajności. Do renderowania zaawansowanych scen trójwymiarowych lub trenowania dużych modeli AI potrzebne mogą być znacznie mocniejsze podzespoły.
Właściwy dobór sprzętu polega na znalezieniu równowagi między wydajnością, ceną, zużyciem energii i możliwościami rozbudowy.
Szczegółowe działanie poszczególnych komponentów omówimy w kolejnym rozdziale.
2.5. Oprogramowanie — instrukcje dla komputera
Komputer potrzebuje instrukcji, aby wykonywać zadania. Za ich dostarczanie odpowiada oprogramowanie.
Możemy podzielić je na kilka podstawowych kategorii.
Oprogramowanie systemowe zarządza pracą urządzenia. Najważniejszym przykładem jest system operacyjny.
Oprogramowanie użytkowe pomaga wykonywać konkretne zadania, takie jak pisanie dokumentów, przeglądanie stron, komunikacja, edycja grafiki czy odtwarzanie multimediów.
Oprogramowanie programistyczne obejmuje narzędzia używane do tworzenia i testowania innych programów. Należą do nich edytory kodu, kompilatory, debugery i środowiska programistyczne.
Oprogramowanie serwerowe obsługuje usługi dostępne dla innych urządzeń lub aplikacji, na przykład strony internetowe, bazy danych i systemy komunikacyjne.
Każda z tych kategorii ma inne przeznaczenie, ale wszystkie opierają się na instrukcjach wykonywanych przez odpowiednie środowisko sprzętowe i programowe.
2.5.1. Jak program komunikuje się ze sprzętem?
Współczesne aplikacje zazwyczaj nie sterują bezpośrednio każdym elementem sprzętu. Korzystają z usług systemu operacyjnego, bibliotek i sterowników.
Przykładowo aplikacja odtwarzająca muzykę przekazuje dane do odpowiednich komponentów systemu, które obsługują dźwięk i komunikację ze sprzętem audio.
Takie warstwy pośredniczące ułatwiają tworzenie oprogramowania. Programista nie musi samodzielnie projektować każdego szczegółu działania karty dźwiękowej czy kontrolera dysku.
Dzięki temu można budować coraz bardziej złożone aplikacje, wykorzystując gotowe mechanizmy i narzędzia.
2.6. Programowanie — podstawa tworzenia technologii
Programowanie polega na tworzeniu instrukcji, które komputer może wykonać.
Programista opisuje, jakie działania ma podejmować aplikacja, jak powinna reagować na dane wejściowe oraz jakie wyniki ma przedstawiać użytkownikowi.
Do tworzenia oprogramowania wykorzystuje się różne języki programowania. Każdy z nich ma określone cechy, składnię i typowe zastosowania.
Przykładowe języki to Python, JavaScript, Java, C# i C++.
Python jest często wybierany przez osoby rozpoczynające naukę programowania. Ma stosunkowo czytelną składnię i jest wykorzystywany między innymi w automatyzacji, analizie danych, tworzeniu aplikacji i rozwoju sztucznej inteligencji.
Rozważmy prosty program:
name = input(„Jak masz na imię? ”)
print(„Witaj,”, name)
Program wyświetla pytanie o imię, pobiera odpowiedź użytkownika i przedstawia powitanie.
Choć przykład jest prosty, pokazuje podstawową zasadę programowania: dane wejściowe mogą być przetwarzane zgodnie z instrukcjami, a następnie wykorzystywane do uzyskania określonego wyniku.
W bardziej rozbudowanych programach pojawiają się zmienne, warunki, pętle, funkcje, struktury danych i mechanizmy obsługi błędów.
Programowanie pozwala tworzyć narzędzia, które rozwiązują konkretne problemy. Może to być aplikacja do zarządzania domowym budżetem, system rezerwacji, program analizujący dane albo asystent wykorzystujący sztuczną inteligencję.
Warto podkreślić, że programowanie nie polega wyłącznie na zapamiętywaniu składni języka. Równie ważne są logiczne myślenie, rozbijanie problemów na mniejsze części, testowanie rozwiązań i umiejętność poprawiania błędów.
2.7. Dane — paliwo współczesnych systemów
Dane są jednym z najważniejszych zasobów współczesnego świata cyfrowego.
Mogą przyjmować postać tekstu, liczb, zdjęć, nagrań dźwiękowych, filmów, pomiarów z czujników lub zapisów dotyczących działania aplikacji.
Systemy informatyczne gromadzą dane, przetwarzają je i wykorzystują do realizacji określonych zadań.
Przykładowo aplikacja pogodowa pobiera pomiary i informacje meteorologiczne, analizuje je, a następnie przedstawia użytkownikowi prognozę.
Sklep internetowy wykorzystuje dane o produktach, zamówieniach i dostępności towarów. System analityczny może natomiast badać zachowania użytkowników i pomagać w identyfikowaniu trendów.
Dane mają również kluczowe znaczenie dla sztucznej inteligencji. Modele uczenia maszynowego są trenowane na przykładach, na podstawie których uczą się rozpoznawać wzorce i wykonywać określone zadania.
Jakość danych wpływa na jakość wyników. Niekompletne, błędne lub niereprezentatywne dane mogą prowadzić do nieprawidłowych wniosków.
Dlatego istotne są nie tylko ilość informacji, ale także ich jakość, pochodzenie, aktualność i sposób wykorzystania.
Nie można również pomijać kwestii prywatności. Dane osobowe powinny być przetwarzane zgodnie z obowiązującymi przepisami i z uwzględnieniem odpowiednich zabezpieczeń.
W świecie nowoczesnych technologii umiejętność odpowiedzialnego zarządzania danymi staje się równie ważna jak zdolność ich analizowania.
2.8. Internet i połączenie świata cyfrowego
Internet jest globalną siecią połączonych ze sobą sieci komputerowych. Umożliwia wymianę danych pomiędzy urządzeniami, serwerami i usługami rozmieszczonymi na całym świecie.
Dzięki internetowi możemy korzystać z poczty elektronicznej, komunikatorów, serwisów informacyjnych, bankowości internetowej, platform edukacyjnych i usług rozrywkowych.
Jedną z najczęściej wykorzystywanych usług internetowych jest World Wide Web, czyli system stron i zasobów dostępnych za pomocą przeglądarek.
Internet i WWW nie oznaczają dokładnie tego samego. Internet jest infrastrukturą sieciową, natomiast WWW to jedna z usług działających na jej podstawie.
Współczesne usługi internetowe często opierają się na architekturze klient–serwer. Klient, na przykład przeglądarka, wysyła żądanie, a serwer przetwarza je i zwraca odpowiedź.
W niektórych rozwiązaniach wykorzystywane są również inne modele komunikacji, systemy rozproszone i mechanizmy bezpośredniej wymiany danych.
Internet umożliwia także korzystanie z aplikacji działających w chmurze. Użytkownik może pracować na dokumentach, edytować materiały lub korzystać z narzędzi AI bez instalowania wszystkich komponentów na własnym urządzeniu.
Jednocześnie należy pamiętać o bezpieczeństwie. Połączenie z internetem wiąże się z koniecznością ochrony kont, urządzeń i przesyłanych informacji.
2.9. Chmura obliczeniowa i nowoczesne usługi
Jeszcze kilkanaście lat temu wiele programów wymagało instalacji bezpośrednio na komputerze użytkownika, a pliki przechowywano przede wszystkim na lokalnych dyskach.
Obecnie coraz więcej usług korzysta z infrastruktury chmurowej.
Chmura obliczeniowa umożliwia zdalne korzystanie z mocy obliczeniowej, pamięci masowej, baz danych i gotowych platform programistycznych.
W praktyce oznacza to, że użytkownik nie zawsze musi posiadać własny, bardzo wydajny komputer, aby korzystać z zaawansowanych narzędzi.
Przykładowo aplikacja może działać na serwerze w centrum danych, a użytkownik komunikuje się z nią za pomocą przeglądarki internetowej.
Takie rozwiązanie pozwala dostawcy centralnie aktualizować oprogramowanie i zarządzać infrastrukturą. Ułatwia również obsługę dużej liczby użytkowników.
Chmura ma jednak również ograniczenia. Korzystanie z niej może wymagać stałego połączenia internetowego, wiązać się z opłatami i powodować konieczność powierzenia części danych zewnętrznemu dostawcy.
Przy wyborze rozwiązania należy uwzględnić koszty, bezpieczeństwo, prywatność, wymagania techniczne i zasady przechowywania informacji.
2.9.1. Chmura a sztuczna inteligencja
Zaawansowane modele AI mogą wymagać znacznej mocy obliczeniowej i dużej ilości pamięci.
Uruchamianie ich w chmurze pozwala korzystać z zasobów serwerowych bez konieczności kupowania odpowiedniego sprzętu.
Użytkownik wysyła dane do usługi, model wykonuje obliczenia, a następnie zwraca wynik. W zależności od rozwiązania proces może być realizowany w całości lub częściowo na urządzeniu użytkownika.
Trzeba jednak pamiętać, że wysyłanie danych do zewnętrznej usługi może wiązać się z ryzykiem dla prywatności. Przed wykorzystaniem narzędzia warto sprawdzić jego zasady przetwarzania danych i unikać przekazywania informacji poufnych, jeśli nie ma ku temu odpowiednich podstaw i zabezpieczeń.
2.10. IT, AI i VR — trzy technologie, jeden kierunek rozwoju
Technologia informacyjna, sztuczna inteligencja i rzeczywistość wirtualna są odrębnymi obszarami, ale coraz częściej współpracują ze sobą.
IT dostarcza podstawową infrastrukturę: komputery, sieci, oprogramowanie, bazy danych i mechanizmy bezpieczeństwa.
AI rozszerza możliwości systemów informatycznych o analizę danych, rozpoznawanie wzorców, generowanie treści i automatyzację wybranych zadań.
VR, czyli Virtual Reality, pozwala tworzyć interaktywne środowiska cyfrowe, w których użytkownik może doświadczać wirtualnej przestrzeni za pomocą specjalnych urządzeń.
Połączenie tych technologii otwiera nowe możliwości.
Wyobraźmy sobie środowisko szkoleniowe, w którym pracownik zakłada gogle VR i trafia do realistycznej symulacji miejsca pracy. Wirtualne otoczenie reaguje na jego działania, a system AI może analizować przebieg ćwiczenia i udzielać informacji zwrotnej.
Podobne rozwiązania mogą znaleźć zastosowanie w edukacji, medycynie, przemyśle, projektowaniu i rozrywce.
Innym przykładem jest wirtualny asystent, z którym użytkownik może rozmawiać w trójwymiarowym środowisku. Sztuczna inteligencja odpowiada za przetwarzanie języka i generowanie odpowiedzi, system VR prezentuje wirtualną postać, a infrastruktura IT umożliwia komunikację oraz obsługę aplikacji.
Nie wszystkie takie rozwiązania są już powszechnie dostępne, a ich możliwości zależą od zastosowanej technologii. Kierunek rozwoju jest jednak wyraźny: systemy informatyczne coraz częściej łączą przetwarzanie danych, inteligentne funkcje i interaktywne środowiska.
2.11. Znaczenie IT w codziennym życiu
Technologia informacyjna wpływa na wiele obszarów naszego życia.
W pracy umożliwia automatyzację procesów, współpracę na odległość i szybki dostęp do dokumentów. W edukacji zapewnia dostęp do materiałów, kursów internetowych i narzędzi wspomagających naukę.
W medycynie systemy informatyczne pomagają zarządzać dokumentacją, analizować wyniki badań i wspierać pracę personelu. W przemyśle służą do monitorowania produkcji, sterowania maszynami i kontrolowania jakości.
W życiu prywatnym korzystamy z aplikacji bankowych, komunikatorów, platform filmowych, sklepów internetowych i systemów nawigacji.
Wiele tych rozwiązań działa tak sprawnie, że przestajemy zauważać stojącą za nimi infrastrukturę.
Jednocześnie rozwój IT przynosi nowe wyzwania. Należą do nich ochrona prywatności, cyberbezpieczeństwo, uzależnienie od usług cyfrowych, dostępność technologii oraz odpowiedzialne wykorzystanie sztucznej inteligencji.
Sama dostępność technologii nie gwarantuje jeszcze, że będzie ona używana właściwie. Potrzebna jest również wiedza, krytyczne myślenie i świadomość możliwych konsekwencji.
2.12. Podsumowanie rozdziału
Technologia informacyjna stanowi fundament współczesnego świata cyfrowego. Obejmuje sprzęt komputerowy, oprogramowanie, sieci, bazy danych, cyberbezpieczeństwo, chmurę obliczeniową i wiele innych dziedzin.
Poszczególne elementy IT współpracują ze sobą, tworząc systemy, które umożliwiają przechowywanie informacji, wykonywanie obliczeń i komunikację między urządzeniami.
Programowanie pozwala tworzyć oprogramowanie dostosowane do określonych potrzeb, a dane stanowią podstawę działania wielu współczesnych usług i systemów analitycznych.
Sztuczna inteligencja rozszerza możliwości klasycznych systemów informatycznych, natomiast rzeczywistość wirtualna tworzy nowe sposoby interakcji z cyfrowym światem.
Najważniejsze jest zrozumienie, że te technologie nie funkcjonują w całkowitej izolacji. Ich możliwości wynikają z połączenia sprzętu, oprogramowania, danych, infrastruktury i wiedzy ludzi, którzy je projektują oraz wykorzystują.
Znajomość podstaw IT ułatwia zrozumienie kolejnych zagadnień. Pozwala świadomiej wybierać sprzęt, korzystać z aplikacji, oceniać możliwości nowych narzędzi i dostrzegać zarówno korzyści, jak i ograniczenia nowoczesnych rozwiązań.
W następnym rozdziale przejdziemy od ogólnego obrazu technologii informacyjnej do wnętrza komputera. Przyjrzymy się procesorowi, pamięci RAM, dyskom, karcie graficznej i innym elementom, które wspólnie umożliwiają działanie cyfrowego świata.
ROZDZIAŁ 3
JAK DZIAŁA KOMPUTER?
3.1. Komputer — maszyna, która przetwarza informacje
Komputery stały się nieodłączną częścią naszego życia. Korzystamy z nich w pracy, szkole, domu i podczas rozrywki. Towarzyszą nam w postaci laptopów, komputerów stacjonarnych, smartfonów, tabletów, konsol do gier, a nawet urządzeń, które na pierwszy rzut oka nie przypominają tradycyjnych komputerów.
Codziennie wykonują miliony operacji, często w czasie krótszym, niż jesteśmy w stanie zauważyć. Odtwarzają filmy, obsługują programy, łączą się z internetem, przechowują zdjęcia, analizują dane i umożliwiają komunikację z ludźmi na całym świecie. Coraz częściej wspierają również systemy sztucznej inteligencji oraz urządzenia wykorzystywane w rzeczywistości wirtualnej.
Mimo ogromnych możliwości podstawowa zasada działania komputera pozostaje stosunkowo prosta: komputer przyjmuje dane, przetwarza je zgodnie z określonymi instrukcjami, a następnie przedstawia wynik lub zapisuje go w pamięci.
Można to porównać do pracy człowieka wykonującego zadanie według instrukcji. Najpierw otrzymuje on informacje, następnie analizuje je, podejmuje określone działania i przedstawia rezultat. Komputer realizuje podobny schemat, ale robi to za pomocą układów elektronicznych oraz programu, który określa kolejność wykonywanych operacji.
Warto jednak pamiętać o jednej ważnej różnicy. Komputer nie musi rozumieć zadania tak, jak rozumie je człowiek. Wykonuje operacje zgodnie z instrukcjami zapisanymi w oprogramowaniu. Nawet wtedy, gdy system sprawia wrażenie inteligentnego, jego działanie opiera się na konkretnych mechanizmach obliczeniowych.
Aby lepiej zrozumieć współczesną technologię, należy poznać elementy, które umożliwiają komputerowi pracę.
3.2. Z czego składa się komputer?
Komputer składa się z wielu współpracujących ze sobą podzespołów. Każdy z nich pełni określoną funkcję, a sprawność całego urządzenia zależy od ich wzajemnego dopasowania.
W typowym komputerze stacjonarnym lub laptopie znajdziemy między innymi:
— procesor, czyli CPU;
— pamięć operacyjną RAM;
— płytę główną;
— dysk SSD lub HDD;
— kartę graficzną, czyli GPU;
— układ chłodzenia;
— zasilacz lub system zasilania;
— urządzenia wejścia i wyjścia;
— układy komunikacyjne umożliwiające połączenie z siecią.
Nie każdy komputer ma wszystkie te elementy w postaci oddzielnych podzespołów. W laptopach wiele układów jest zintegrowanych, a w smartfonach większość najważniejszych funkcji może realizować jeden rozbudowany układ elektroniczny, nazywany SoC — System on a Chip.
Z zewnątrz komputer może wyglądać niepozornie. W jego wnętrzu zachodzi jednak skomplikowana współpraca układów, które wymieniają dane i wykonują ogromną liczbę operacji.
Aby zrozumieć ich znaczenie, przyjrzyjmy się najważniejszym częściom.
3.3. Procesor — centrum wykonywania obliczeń
Procesor, określany skrótem CPU od angielskiego Central Processing Unit, jest jednym z najważniejszych elementów komputera. Wykonuje instrukcje programów, przeprowadza obliczenia i koordynuje wiele operacji zachodzących w systemie.
Można porównać go do pracownika, który otrzymuje zadania i wykonuje je zgodnie z określoną kolejnością. W rzeczywistości współczesne procesory są znacznie bardziej skomplikowane. Potrafią wykonywać wiele operacji równolegle, przewidywać część kolejnych instrukcji i optymalizować sposób przetwarzania danych.
3.3.1. Jak działa procesor?
Program składa się z instrukcji, które procesor może wykonać. Instrukcje te są reprezentowane w postaci kodu maszynowego, zrozumiałego dla konkretnej architektury procesora.
W uproszczeniu działanie procesora można przedstawić w kilku etapach:
— Pobranie instrukcji — procesor odczytuje kolejną instrukcję z pamięci lub pamięci podręcznej.
— Dekodowanie — ustala, jakiego rodzaju operację należy wykonać.
— Wykonanie — realizuje operację, na przykład dodawanie liczb albo porównanie wartości.
— Zapis wyniku — wynik może zostać zapisany w rejestrze, pamięci lub przekazany do kolejnego etapu przetwarzania.
Jest to uproszczony model. Nowoczesne procesory stosują między innymi potokowe przetwarzanie instrukcji, wykonywanie poza kolejnością oraz przewidywanie rozgałęzień. Dzięki temu mogą efektywniej wykorzystywać dostępne zasoby.
Wyobraźmy sobie prosty program obliczający sumę dwóch liczb. Procesor musi pobrać odpowiednie dane, wykonać operację dodawania i udostępnić wynik. Z perspektywy użytkownika wszystko odbywa się niemal natychmiast.
Podobny mechanizm, choć znacznie bardziej złożony, wykorzystywany jest podczas uruchamiania gier, edycji filmów, pracy z arkuszami kalkulacyjnymi czy obsługi aplikacji internetowych.
3.3.2. Rdzenie i wątki
Współczesne procesory mają zwykle wiele rdzeni. Każdy rdzeń jest w stanie wykonywać instrukcje, dzięki czemu komputer może realizować różne zadania jednocześnie.
Przykładowo podczas pracy na komputerze możemy słuchać muzyki, pobierać pliki, korzystać z przeglądarki internetowej i edytować dokument. System operacyjny rozdziela pracę pomiędzy dostępne zasoby procesora, tak aby aplikacje mogły działać sprawnie.
Ważnym pojęciem jest również wątek. Wątek reprezentuje ciąg wykonywanych instrukcji, którym system może przydzielać czas procesora. Niektóre procesory umożliwiają jednoczesną obsługę więcej niż jednego wątku na pojedynczym rdzeniu dzięki odpowiednim mechanizmom sprzętowym.
Większa liczba rdzeni może poprawić wydajność w zadaniach, które potrafią wykorzystywać przetwarzanie równoległe. Nie oznacza jednak, że każdy program będzie działał szybciej. Wiele zależy od sposobu zaprojektowania oprogramowania.
3.3.3. Częstotliwość taktowania
Jednym z parametrów procesora jest częstotliwość taktowania, wyrażana najczęściej w gigahercach, czyli GHz.
Częstotliwość określa liczbę cykli zegara na sekundę. Nie należy jednak utożsamiać jej bezpośrednio z liczbą wykonywanych instrukcji. Różne procesory mogą wykonywać różną liczbę operacji w jednym cyklu, a wydajność zależy również od architektury, pamięci podręcznej, limitów energetycznych i rodzaju obciążenia.
Dlatego procesor o wyższej częstotliwości nie zawsze będzie szybszy od modelu pracującego z niższą częstotliwością.
Przy wyborze komputera warto analizować całą specyfikację oraz wyniki testów odpowiadających planowanemu zastosowaniu.
3.3.4. Procesor a sztuczna inteligencja
Procesory CPU są wykorzystywane również w zadaniach związanych ze sztuczną inteligencją. Mogą obsługiwać modele uczenia maszynowego, przygotowywać dane, zarządzać aplikacjami i wykonywać obliczenia związane z ich działaniem.
Nie wszystkie zadania AI są jednak dla CPU równie efektywne. Duże modele, rozbudowane sieci neuronowe i operacje na ogromnych zbiorach danych często korzystają z wyspecjalizowanych układów, takich jak GPU czy akceleratory AI.
Procesor nadal odgrywa istotną rolę, ale w nowoczesnych systemach jest częścią większego środowiska obliczeniowego.
3.4. Pamięć RAM — przestrzeń robocza komputera
Drugim kluczowym elementem jest pamięć RAM, czyli Random Access Memory.
RAM przechowuje dane i instrukcje, które są aktualnie potrzebne uruchomionym programom. Można ją porównać do biurka, na którym rozkładamy dokumenty potrzebne do wykonania zadania.
Jeżeli na biurku jest wystarczająco dużo miejsca, możemy wygodnie pracować z wieloma dokumentami. Gdy miejsca zaczyna brakować, musimy odkładać część materiałów i ponownie po nie sięgać. Podobnie komputer potrzebuje odpowiedniej ilości pamięci operacyjnej, aby sprawnie obsługiwać wiele aplikacji.
3.4.1. Dlaczego RAM jest tak ważna?
Załóżmy, że uruchamiamy przeglądarkę internetową, program graficzny i kilka dokumentów. Każda z tych aplikacji potrzebuje przestrzeni na swoje dane. System operacyjny oraz inne procesy również wykorzystują pamięć.
Jeżeli dostępnej pamięci RAM jest wystarczająco dużo, komputer może przechowywać potrzebne dane w pamięci operacyjnej. Jeśli zaczyna jej brakować, system może przenosić część danych do pliku stronicowania lub innego mechanizmu pamięci wirtualnej.
Ponieważ dysk jest zazwyczaj znacznie wolniejszy od RAM, intensywne korzystanie z pamięci wirtualnej może powodować spadek płynności pracy.
Właśnie dlatego ilość RAM ma duże znaczenie przy pracy z wieloma programami, obróbce zdjęć, montażu wideo, projektowaniu 3D oraz korzystaniu z narzędzi AI.
3.4.2. Czy więcej pamięci RAM zawsze oznacza szybszy komputer?
Nie zawsze. Jeżeli komputer ma wystarczająco dużo RAM do wykonywania określonych zadań, zwiększenie jej ilości może nie przynieść zauważalnego przyspieszenia.
Jeśli jednak pamięci jest za mało, jej rozbudowa może znacząco poprawić komfort pracy.
Przykładowo komputer używany głównie do prostych dokumentów i przeglądania stron ma inne wymagania niż stacja robocza przeznaczona do edycji wideo, projektowania trójwymiarowego czy uruchamiania lokalnych modeli sztucznej inteligencji.
Ważna jest również kompatybilność pamięci z płytą główną i procesorem, jej szybkość oraz możliwość późniejszej rozbudowy.
3.4.3. Czy RAM przechowuje dane na stałe?
Nie. Typowa pamięć RAM jest pamięcią ulotną. Oznacza to, że po odłączeniu zasilania jej zawartość zostaje utracona.
Dokument zapisany na dysku pozostanie tam po wyłączeniu komputera. Niezapisane zmiany przechowywane wyłącznie w pamięci operacyjnej mogą natomiast zniknąć.
Dlatego pamięć RAM i dysk pełnią zupełnie inne funkcje, mimo że oba elementy przechowują dane.
3.5. Płyta główna — element łączący podzespoły
Płyta główna jest podstawową płytką elektroniczną, do której podłącza się wiele elementów komputera.
Znajdują się na niej gniazda procesora, sloty pamięci RAM, złącza dla dysków, układy komunikacyjne oraz porty umożliwiające podłączanie urządzeń zewnętrznych. Płyta główna zapewnia także połączenia elektryczne i ścieżki komunikacyjne między podzespołami.
Można porównać ją do infrastruktury drogowej w dużym mieście. Poszczególne miejsca muszą być połączone, aby ludzie i towary mogły przemieszczać się między nimi. W komputerze zamiast samochodów przemieszczają się dane i sygnały.
3.5.1. Kompatybilność podzespołów
Nie każdy procesor pasuje do każdej płyty głównej. Podobnie nie wszystkie rodzaje pamięci RAM mogą być stosowane w dowolnym komputerze.
Przy budowie lub modernizacji komputera należy sprawdzić między innymi:
— zgodność procesora z gniazdem i chipsetem płyty głównej;
— obsługiwany typ pamięci RAM;
— liczbę oraz rodzaj dostępnych złączy;
— obsługiwane standardy dysków;
— możliwości rozbudowy;
— wymagania dotyczące zasilania i chłodzenia.
Wybór płyty głównej wpływa więc na możliwości całego zestawu. Dobrze dobrana płyta pozwala stworzyć stabilny system, który można później rozbudować zgodnie z potrzebami.
3.6. Dysk SSD i HDD — gdzie komputer przechowuje dane?
Pamięć RAM jest tymczasowa, dlatego komputer potrzebuje również miejsca na trwałe przechowywanie systemu operacyjnego, programów i plików użytkownika.
Tę funkcję pełnią dyski. Najczęściej spotykamy dwa rodzaje: HDD oraz SSD.
3.6.1. Dysk HDD
HDD, czyli Hard Disk Drive, to dysk wykorzystujący obracające się talerze magnetyczne i mechanizm odczytu oraz zapisu danych.
Technologia ta jest rozwijana od wielu dekad. Dyski HDD nadal są stosowane, szczególnie tam, gdzie istotna jest duża pojemność przy relatywnie niskim koszcie przechowywania danych.
Ich ograniczeniem jest obecność elementów mechanicznych. W porównaniu z nowoczesnymi dyskami SSD zwykle oferują znacznie dłuższy czas dostępu do danych i niższą wydajność przy wielu drobnych operacjach odczytu oraz zapisu.
3.6.2. Dysk SSD
SSD, czyli Solid-State Drive, przechowuje dane w pamięci półprzewodnikowej, bez obracających się talerzy.
W praktyce dyski SSD zapewniają znacznie szybsze uruchamianie systemu, sprawniejsze wczytywanie aplikacji i krótszy czas otwierania wielu plików.
Istnieją różne rodzaje SSD. Spotykamy między innymi modele SATA oraz NVMe korzystające z interfejsu PCI Express. Różnią się one między innymi osiąganą przepustowością i opóźnieniami.
W typowym komputerze domowym przejście z HDD na SSD często jest jedną z najbardziej odczuwalnych modernizacji.
3.6.3. Dysk a pamięć operacyjna — podstawowa różnica
RAM służy do przechowywania danych potrzebnych podczas bieżącej pracy, natomiast dysk przechowuje pliki również po wyłączeniu urządzenia.
Możemy wyobrazić sobie taką sytuację: dokument znajduje się na dysku, ale po jego otwarciu program wczytuje potrzebne dane do pamięci operacyjnej. Procesor wykonuje instrukcje, a zmiany są następnie zapisywane na dysku.
Ten proces nie zawsze przebiega w tak prosty sposób, ponieważ systemy operacyjne wykorzystują pamięć podręczną, buforowanie i wiele mechanizmów optymalizacyjnych. Przykład dobrze jednak pokazuje podstawowy podział funkcji.
3.6.4. Dlaczego dyski są ważne dla AI?
Praca ze sztuczną inteligencją może wymagać przechowywania dużych zbiorów danych, plików treningowych, modeli i wyników obliczeń.
W takich zastosowaniach znaczenie mają zarówno pojemność, jak i wydajność dysku. Szybki nośnik może skrócić czas wczytywania danych i modeli, ale nie zastąpi odpowiednio mocnego procesora, wystarczającej ilości RAM ani GPU, jeśli zadanie wymaga intensywnych obliczeń.
Każdy podzespół odpowiada za inną część procesu.
3.7. Karta graficzna — nie tylko do gier
Karta graficzna odpowiada za przetwarzanie i generowanie obrazu. W zależności od konstrukcji może być zintegrowana z procesorem albo występować jako oddzielny podzespół.
GPU to skrót od Graphics Processing Unit. Układy tego rodzaju są projektowane z myślą o wykonywaniu określonych typów obliczeń z dużą równoległością.
3.7.1. Grafika zintegrowana i dedykowana
Grafika zintegrowana jest częścią procesora lub innego układu, który realizuje także pozostałe funkcje komputera. W wielu zastosowaniach biurowych, internetowych i multimedialnych jest wystarczająca.
Karta dedykowana to oddzielny układ graficzny, zwykle wyposażony we własną pamięć VRAM. Takie rozwiązania mogą oferować znacznie większą wydajność w grach, renderowaniu 3D, montażu wideo i wybranych zadaniach obliczeniowych.
Nie oznacza to, że każdy użytkownik potrzebuje drogiej karty graficznej. Wybór powinien zależeć od konkretnych zastosowań.
3.7.2. Dlaczego GPU jest ważne w sztucznej inteligencji?
Współczesne modele uczenia maszynowego często wykonują bardzo wiele operacji matematycznych na dużych zbiorach danych. Szczególnie ważne są operacje na macierzach i wektorach, które mogą być efektywnie realizowane przez odpowiednio zaprojektowane GPU.
Z tego powodu karty graficzne stały się istotnym narzędziem w trenowaniu i uruchamianiu wielu modeli AI.
Nie wszystkie modele i zadania wymagają jednak GPU. Mniejsze modele mogą działać na CPU, a niektóre urządzenia wykorzystują wyspecjalizowane akceleratory.
W praktyce możliwości uruchamiania AI lokalnie zależą między innymi od architektury układu, ilości dostępnej pamięci, optymalizacji oprogramowania oraz rozmiaru modelu.
3.7.3. GPU i rzeczywistość wirtualna
Rzeczywistość wirtualna, czyli VR, stawia przed komputerem dodatkowe wymagania. System musi generować obraz dla obu oczu, często przy wysokiej częstotliwości odświeżania i z zachowaniem niewielkich opóźnień.
Jeżeli komputer nie jest w stanie dostarczać obrazu wystarczająco szybko, użytkownik może zauważyć spadek płynności, a komfort korzystania z gogli może się pogorszyć.
GPU ma więc istotne znaczenie dla jakości doświadczeń VR. Równie ważne pozostają jednak procesor, optymalizacja aplikacji, parametry gogli i sposób połączenia urządzeń.
3.8. Zasilanie i chłodzenie — stabilność ma znaczenie
Komputer potrzebuje energii elektrycznej, a podczas pracy część tej energii zamienia się w ciepło.
W komputerach stacjonarnych za dostarczanie odpowiedniego napięcia odpowiada zasilacz. W laptopach funkcję tę realizuje układ zasilania współpracujący z zasilaczem zewnętrznym i akumulatorem.
Zasilacz musi zapewniać odpowiednią moc, jakość zasilania i zgodność ze stosowanymi podzespołami. Nie warto dobierać go wyłącznie na podstawie najniższej ceny.
3.8.1. Skąd bierze się ciepło?
Procesor, GPU i inne układy elektroniczne pobierają energię podczas pracy. Część tej energii jest rozpraszana w postaci ciepła.
Im większe obciążenie i pobór mocy, tym większe mogą być wymagania dotyczące chłodzenia. Dlatego komputery wykorzystują radiatory, wentylatory, a w bardziej rozbudowanych konstrukcjach również układy chłodzenia cieczą.
3.8.2. Co się dzieje, gdy komputer jest zbyt gorący?
Wysoka temperatura może powodować ograniczenie częstotliwości pracy procesora lub GPU. Mechanizm ten, nazywany throttlingiem termicznym, pozwala ograniczyć temperaturę i chronić podzespoły.
Użytkownik może wówczas zauważyć spadek wydajności, szczególnie podczas długotrwałego obciążenia.
Regularne czyszczenie komputera z kurzu, sprawne wentylatory i prawidłowy przepływ powietrza pomagają utrzymać stabilne warunki pracy. W przypadku laptopów ważne jest również korzystanie z urządzenia na powierzchni, która nie blokuje otworów wentylacyjnych.
3.9. Urządzenia wejścia i wyjścia
Komputer nie działa w oderwaniu od użytkownika. Potrzebuje sposobu odbierania poleceń i przedstawiania wyników.
Urządzenia wejścia pozwalają przekazywać dane do komputera. Należą do nich między innymi:
— klawiatura;
— mysz;
— mikrofon;
— kamera;
— skaner;
— ekran dotykowy;
— kontrolery wykorzystywane w grach i VR.
Urządzenia wyjścia prezentują wyniki działania systemu. Przykładami są:
— monitor;
— głośniki;
— słuchawki;
— drukarka;
— projektor;
— gogle rzeczywistości wirtualnej.
Niektóre urządzenia pełnią jednocześnie funkcje wejścia i wyjścia. Ekran dotykowy wyświetla obraz, ale również rejestruje dotyk. Gogle VR prezentują obraz, a często współpracują z czujnikami śledzącymi ruch głowy i kontrolerami rejestrującymi ruch dłoni.
Dzięki temu komputer może nie tylko wyświetlać informacje, lecz także odbierać sygnały z otoczenia i reagować na działania człowieka.
3.10. Co dzieje się po naciśnięciu przycisku zasilania?
Uruchomienie komputera wydaje się prostą czynnością. W rzeczywistości rozpoczyna się wtedy sekwencja operacji, dzięki którym sprzęt przechodzi od stanu wyłączenia do gotowości do pracy.
Etap 1. Zasilanie
Po naciśnięciu przycisku uruchamiania system zasilania inicjuje pracę odpowiednich układów. W komputerze stacjonarnym zasilacz dostarcza energię do podzespołów zgodnie z konstrukcją urządzenia.
Etap 2. Firmware
Procesor rozpoczyna wykonywanie kodu inicjującego system, przechowywanego w pamięci nieulotnej. Współczesne komputery PC wykorzystują zwykle firmware UEFI, choć starsze urządzenia mogą korzystać z tradycyjnego BIOS-u.
Firmware przygotowuje sprzęt do dalszej pracy i uruchamia procedury startowe.
Etap 3. Test i inicjalizacja sprzętu
System sprawdza podstawowe elementy komputera oraz inicjalizuje urządzenia potrzebne do uruchomienia systemu operacyjnego. Zakres testów zależy od konstrukcji urządzenia i konfiguracji firmware.
Etap 4. Wybór urządzenia startowego
Firmware ustala, skąd należy rozpocząć uruchamianie systemu. Zwykle jest to dysk zawierający odpowiednie pliki startowe.
Etap 5. Uruchomienie programu rozruchowego
Program rozruchowy przygotowuje uruchomienie systemu operacyjnego i przekazuje mu sterowanie.
Etap 6. Ładowanie systemu operacyjnego
System operacyjny inicjalizuje własne komponenty, ładuje niezbędne sterowniki i uruchamia usługi systemowe.
Etap 7. Gotowość do pracy
Po zakończeniu wymaganych czynności użytkownik może zalogować się do systemu i uruchamiać aplikacje.
Przebieg uruchamiania może różnić się w zależności od systemu operacyjnego, konfiguracji sprzętu, zastosowanych zabezpieczeń i sposobu wyłączania urządzenia. Niektóre systemy wykorzystują także mechanizmy szybkiego uruchamiania, które skracają część procedur.
Mimo tej złożoności cały proces często trwa zaledwie kilka lub kilkanaście sekund.
3.11. Jak komputer wykonuje program?
Kiedy uruchamiamy aplikację, system operacyjny przygotowuje środowisko potrzebne do jej działania.
Wczytywane są odpowiednie dane, przydzielana jest pamięć, a procesor rozpoczyna wykonywanie instrukcji programu. Jeżeli aplikacja potrzebuje grafiki, dźwięku, połączenia internetowego lub dostępu do plików, korzysta z odpowiednich mechanizmów systemowych i sterowników.
Rozważmy prosty przykład: otwieramy kalkulator i wpisujemy działanie 25 +17.
— Użytkownik wprowadza liczby za pomocą klawiatury lub interfejsu ekranowego.
— Aplikacja odbiera dane i interpretuje polecenie.
— Program wykonuje odpowiednią operację arytmetyczną.
— Wynik zostaje przedstawiony w interfejsie.
— System wyświetla rezultat na ekranie.
Wynikiem jest liczba 42.
W bardziej złożonych aplikacjach podobna zasada obejmuje tysiące lub miliony operacji. Program może odczytywać pliki, komunikować się z serwerami, przetwarzać obraz albo korzystać z modelu sztucznej inteligencji.
Komputer nie wykonuje jednak wszystkich zadań wyłącznie za pomocą procesora. W zależności od potrzeb korzysta z pamięci, GPU, układów dźwiękowych, kontrolerów dysków i innych elementów.
Wydajność zależy więc nie tylko od jednego podzespołu, ale od współpracy całego systemu.
3.12. System binarny — język, na którym opiera się komputer
Człowiek posługuje się na co dzień systemem dziesiętnym. Zapisujemy liczby za pomocą dziesięciu cyfr: od 0 do 9.
Komputery cyfrowe wykorzystują natomiast reprezentację binarną, opartą na dwóch wartościach: 0 i 1.
Podstawową jednostką informacji jest bit. Bit może przyjmować jedną z dwóch wartości. Osiem bitów tworzy bajt, który jest powszechnie stosowany jako jednostka ilości danych.
W praktyce pojedynczy bit może być reprezentowany przez różne stany fizyczne, zależnie od technologii. W układach elektronicznych są to na przykład odpowiednio interpretowane poziomy napięcia lub stany tranzystorów.
3.12.1. Dlaczego dwa stany?
Układy cyfrowe projektuje się tak, aby potrafiły rozróżniać określone stany. Dwa podstawowe stany logiczne ułatwiają budowanie niezawodnych obwodów i wykonywanie operacji logicznych.
Z bitów można tworzyć większe struktury danych, które reprezentują liczby, znaki tekstowe, kolory, dźwięki, instrukcje programów i wiele innych informacji.
Przykładowo liczba 5 w systemie dziesiętnym ma zapis 101 w systemie binarnym.
Można to sprawdzić, pamiętając, że kolejne pozycje w zapisie binarnym odpowiadają potęgom liczby 2:
— 1 × 4;
— 0 × 2;
— 1 × 1.
Suma wynosi 5.
Współczesne komputery wykonują znacznie bardziej złożone operacje niż proste przeliczanie liczb. Podstawą pozostają jednak układy cyfrowe, które realizują operacje logiczne i arytmetyczne.
3.12.2. Czy wszystko w komputerze jest zapisane jako 0 i 1?
Na poziomie cyfrowej reprezentacji danych — zasadniczo tak. Nie oznacza to jednak, że wszystkie informacje mają taką samą strukturę.
Tekst może być kodowany za pomocą standardów takich jak Unicode. Obraz jest reprezentowany przez dane opisujące piksele lub inną strukturę graficzną. Dźwięk cyfrowy może składać się z próbek opisujących sygnał w kolejnych chwilach.
Oprogramowanie interpretuje te dane zgodnie z ich formatem i przeznaczeniem.
Dlatego ten sam ciąg bitów może oznaczać coś innego w zależności od tego, czy zostanie zinterpretowany jako liczba, fragment tekstu, instrukcja procesora czy część pliku graficznego.
3.13. Dlaczego komputery mają różną wydajność?
Dwa komputery mogą wyglądać podobnie, a mimo to działać z zupełnie inną szybkością. Różnice wynikają z zastosowanych podzespołów, ich konfiguracji oraz rodzaju wykonywanych zadań.
Najważniejsze czynniki to:
Procesor. Wpływa na szybkość wykonywania instrukcji i obsługę wielu zadań.
Pamięć RAM. Określa, ile danych i aplikacji system może wygodnie obsługiwać w pamięci operacyjnej.
Dysk. Ma znaczenie dla uruchamiania systemu, wczytywania programów i pracy z plikami.
GPU. Odpowiada za grafikę i może przyspieszać określone obliczenia równoległe.
Chłodzenie. Pomaga utrzymać wydajność podczas dłuższego obciążenia.
Oprogramowanie. Dobrze zoptymalizowany program może działać sprawniej niż źle napisany odpowiednik, nawet na tym samym sprzęcie.
Konfiguracja systemu. Sterowniki, ustawienia zasilania, działające procesy w tle i stan techniczny urządzenia również mogą wpływać na płynność pracy.
Nie istnieje jeden podzespół, który zawsze decyduje o szybkości komputera. W niektórych zastosowaniach ograniczeniem będzie procesor, w innych GPU, pamięć lub dysk.
W analizie wydajności używa się pojęcia wąskiego gardła. Oznacza ono element, który ogranicza osiągi całego systemu w danym zadaniu.
Przykładowo bardzo mocna karta graficzna nie zapewni oczekiwanej wydajności, jeśli konkretna aplikacja jest ograniczona przez procesor. Z kolei szybki procesor nie rozwiąże problemu zbyt małej ilości pamięci RAM, jeżeli system stale musi przenosić dane między RAM a dyskiem.
Dlatego komputer należy dobierać do zadań, które ma wykonywać, a nie tylko do pojedynczej liczby w specyfikacji.
3.14. Komputer jako podstawa sztucznej inteligencji i VR
Zrozumienie budowy komputera pomaga lepiej poznać technologie, które rozwijają się na naszych oczach.
Sztuczna inteligencja potrzebuje zasobów obliczeniowych do trenowania modeli, analizowania danych i generowania wyników. W zależności od zadania wykorzystuje CPU, GPU, pamięć operacyjną, dyski oraz wyspecjalizowane akceleratory.
Rzeczywistość wirtualna wymaga natomiast sprawnego generowania grafiki, szybkiego przetwarzania informacji o ruchu i utrzymywania odpowiednio niskich opóźnień. W tym przypadku znaczenie mają zarówno możliwości komputera, jak i parametry urządzeń VR.
Technologie te coraz częściej łączą się ze sobą. System VR może wykorzystywać AI do rozpoznawania gestów, generowania postaci, dostosowywania wirtualnego otoczenia czy prowadzenia rozmów z wirtualnymi asystentami.
Za każdym takim rozwiązaniem stoją jednak konkretne komponenty sprzętowe i programowe.
Komputer nie jest więc wyłącznie urządzeniem do przeglądania internetu czy pisania dokumentów. To uniwersalna platforma, na której można budować systemy analizujące dane, symulujące rzeczywistość i automatyzujące zadania.
3.15. Podsumowanie rozdziału
Komputer jest systemem złożonym z wielu współpracujących podzespołów. Każdy z nich odpowiada za określoną część pracy, a ich wspólne działanie pozwala wykonywać zadania od prostych obliczeń po skomplikowane symulacje i obliczenia związane ze sztuczną inteligencją.
Najważniejsze informacje z tego rozdziału:
— CPU wykonuje instrukcje programów i realizuje wiele obliczeń.
— RAM przechowuje dane potrzebne podczas bieżącej pracy.
— Płyta główna łączy podzespoły i umożliwia ich komunikację.
— SSD i HDD służą do trwałego przechowywania danych.
— GPU przetwarza grafikę i przyspiesza wybrane zadania obliczeniowe.
— Zasilanie i chłodzenie pomagają zapewnić stabilną pracę komputera.
— Urządzenia wejścia i wyjścia umożliwiają komunikację między użytkownikiem a systemem.
— System binarny stanowi podstawę cyfrowej reprezentacji informacji.
— System operacyjny zarządza zasobami komputera i umożliwia uruchamianie aplikacji.
Poznanie tych elementów to pierwszy krok do zrozumienia, dlaczego jedne komputery sprawdzają się w prostych zadaniach, a inne są przeznaczone do gier, projektowania 3D, sztucznej inteligencji czy rzeczywistości wirtualnej.
W kolejnych rozdziałach przyjrzymy się oprogramowaniu, systemom operacyjnym i programowaniu. To właśnie one sprawiają, że sprzęt może wykonywać konkretne zadania i staje się użytecznym narzędziem w codziennym życiu.
ROZDZIAŁ 4
SYSTEMY OPERACYJNE I OPROGRAMOWANIE
4.1. Wprowadzenie — sprzęt potrzebuje oprogramowania
W poprzednim rozdziale poznaliśmy najważniejsze elementy komputera. Dowiedzieliśmy się, jaką funkcję pełnią procesor, pamięć RAM, dysk, płyta główna i karta graficzna. Wiemy już, że każdy z tych komponentów odpowiada za określoną część pracy urządzenia.
Sam sprzęt nie wystarczy jednak, aby komputer mógł wykonywać zadania, których oczekuje od niego użytkownik. Potrzebuje instrukcji, które określają sposób działania poszczególnych elementów. Potrzebuje również mechanizmów zarządzających pamięcią, plikami, urządzeniami i uruchomionymi programami.
Za znaczną część tych zadań odpowiada system operacyjny.
To właśnie dzięki niemu możemy włączyć komputer, zalogować się na konto, otworzyć dokument, uruchomić przeglądarkę internetową, zainstalować program i zapisać plik na dysku. System operacyjny tworzy środowisko, w którym sprzęt i aplikacje mogą współpracować.
Współczesny komputer jest więc połączeniem dwóch podstawowych elementów: sprzętu i oprogramowania. Sprzęt zapewnia fizyczne możliwości wykonywania operacji, a oprogramowanie określa, jak te możliwości zostaną wykorzystane.
Zrozumienie tej zależności jest ważne nie tylko dla osób interesujących się informatyką. Przydaje się również podczas codziennego korzystania z komputera, rozwiązywania problemów technicznych oraz poznawania narzędzi sztucznej inteligencji i rzeczywistości wirtualnej.
4.2. Czym jest system operacyjny?
System operacyjny, określany skrótem OS od angielskiego Operating System, to podstawowe oprogramowanie zarządzające zasobami komputera i umożliwiające uruchamianie aplikacji.
Można porównać go do kierownika dużego przedsiębiorstwa. W firmie trzeba rozdzielać zadania, przydzielać zasoby, pilnować terminów i dbać o współpracę różnych działów. W komputerze podobne funkcje realizuje system operacyjny, choć oczywiście robi to za pomocą mechanizmów programowych, a nie ludzkich decyzji.
System operacyjny odpowiada między innymi za:
— zarządzanie procesorem i czasem wykonywania programów;
— przydzielanie i kontrolowanie pamięci operacyjnej;
— obsługę plików i katalogów;
— komunikację z urządzeniami;
— uruchamianie i kończenie procesów;
— zarządzanie kontami użytkowników i uprawnieniami;
— udostępnianie aplikacjom usług systemowych;
— realizację wielu mechanizmów bezpieczeństwa.
Bez systemu operacyjnego korzystanie z typowego komputera byłoby znacznie trudniejsze. Użytkownik musiałby samodzielnie wykonywać wiele czynności, które obecnie odbywają się automatycznie.
Nie wszystkie urządzenia wymagają jednak rozbudowanego systemu operacyjnego z graficznym interfejsem. Proste urządzenia elektroniczne mogą korzystać z oprogramowania wbudowanego, a część systemów działa bezpośrednio na sprzęcie w bardzo wyspecjalizowany sposób.
W komputerach osobistych najczęściej spotykamy jednak systemy operacyjne, które zapewniają wygodne środowisko do codziennej pracy.
4.3. Najpopularniejsze systemy operacyjne
Na rynku istnieje wiele systemów operacyjnych. Różnią się sposobem działania, interfejsem, kompatybilnością, modelem licencjonowania i typowymi zastosowaniami.
Do najbardziej znanych należą Windows, macOS, Linux, Android i iOS.
4.3.1. Windows
Windows to rodzina systemów operacyjnych rozwijanych przez firmę Microsoft. Jest powszechnie wykorzystywana na komputerach osobistych, laptopach i w wielu środowiskach biznesowych.
Jedną z istotnych zalet Windows jest szeroka zgodność z oprogramowaniem użytkowym, grami i różnymi urządzeniami peryferyjnymi. System oferuje graficzny interfejs, obsługę wielu aplikacji jednocześnie i rozbudowane mechanizmy zarządzania urządzeniami.
Windows występuje w różnych edycjach, które mogą różnić się funkcjami, szczególnie w obszarach zarządzania, zabezpieczeń i pracy w organizacjach.
Podczas korzystania z tego systemu użytkownik może instalować programy, organizować pliki, zmieniać ustawienia i zarządzać kontami. W bardziej zaawansowanych zastosowaniach dostępne są również narzędzia administracyjne, wiersz poleceń i środowiska programistyczne.
Windows jest często wybierany przez osoby, które chcą korzystać z szerokiej gamy aplikacji, gier i urządzeń.
4.3.2. macOS
macOS to system operacyjny rozwijany przez firmę Apple dla komputerów Mac.
Charakteryzuje się ścisłą integracją z urządzeniami i usługami Apple. Oferuje graficzny interfejs użytkownika, rozbudowane funkcje multimedialne oraz narzędzia przydatne w pracy twórczej i programowaniu.
Wybór pomiędzy macOS a Windows często zależy od potrzeb użytkownika, posiadanego sprzętu, wymaganego oprogramowania i przyzwyczajeń.
Nie istnieje jeden system, który będzie najlepszy dla każdego. Każdy ma własne zalety, ograniczenia i specyficzne wymagania sprzętowe.
4.3.3. Linux
Linux zajmuje szczególne miejsce w świecie informatyki.
W ścisłym znaczeniu Linux jest jądrem systemu operacyjnego. W codziennym języku nazwą tą określa się jednak często całe systemy oparte na jądrze Linux, rozpowszechniane jako dystrybucje.
Przykładami dystrybucji są Ubuntu, Debian i Fedora. Każda może zawierać inne narzędzia, środowisko graficzne i domyślną konfigurację.
Linux jest szeroko stosowany na serwerach, w chmurze obliczeniowej, systemach wbudowanych, środowiskach programistycznych i wielu narzędziach związanych ze sztuczną inteligencją.
Ważną cechą wielu dystrybucji jest otwartość kodu źródłowego. Umożliwia to jego analizowanie, modyfikowanie i rozwijanie zgodnie z warunkami odpowiednich licencji.
Linux daje dużą elastyczność, ale nie oznacza to, że zawsze będzie najłatwiejszym wyborem. Niektóre programy komercyjne i gry mogą działać na nim inaczej niż w Windows, a określone urządzenia mogą wymagać dodatkowej konfiguracji.
Dla osób uczących się programowania, administracji serwerami lub pracy z narzędziami AI znajomość Linuksa może być jednak bardzo przydatna.
4.3.4. Android i iOS
Smartfony również są komputerami, choć ich konstrukcja i sposób obsługi różnią się od komputerów stacjonarnych.
Android jest systemem rozwijanym przez Google i wykorzystywanym przez wielu producentów urządzeń mobilnych. iOS jest systemem Apple przeznaczonym dla iPhone'ów.
Oba umożliwiają uruchamianie aplikacji, komunikację przez internet, obsługę aparatu, korzystanie z czujników i zarządzanie danymi użytkownika.
Systemy mobilne przykładają dużą wagę do zarządzania energią, uprawnień aplikacji, ochrony danych i dostępu do funkcji urządzenia.
Wraz z rozwojem mobilnych układów obliczeniowych coraz więcej zadań związanych ze sztuczną inteligencją może być wykonywanych bezpośrednio na smartfonie. Dotyczy to między innymi rozpoznawania mowy, analizy obrazu i wybranych funkcji generatywnych.
4.4. Jądro systemu — fundament działania systemu operacyjnego
W sercu wielu systemów operacyjnych znajduje się jądro, określane po angielsku jako kernel.
Jądro odpowiada za podstawowe mechanizmy zarządzania zasobami sprzętowymi oraz komunikację między oprogramowaniem a sprzętem. Jego dokładna architektura zależy od konkretnego systemu.
Do ważnych zadań jądra należą:
— zarządzanie procesami i wątkami;
— przydzielanie pamięci;
— obsługa mechanizmów komunikacji z urządzeniami;
— zapewnianie podstawowych mechanizmów bezpieczeństwa;
— udostępnianie aplikacjom usług za pośrednictwem interfejsów systemowych.
Kiedy program potrzebuje wykonać operację, do której nie ma bezpośredniego dostępu, może zwrócić się do systemu operacyjnego za pomocą odpowiedniego interfejsu.
Przykładowo aplikacja zapisująca plik korzysta z usług systemowych, które umożliwiają zapisanie danych na nośniku. System kontroluje sposób wykonania operacji i sprawdza, czy program ma odpowiednie uprawnienia.
Takie rozwiązanie pomaga izolować aplikacje od siebie oraz ograniczać ryzyko niekontrolowanego dostępu do zasobów.
Jądro nie jest jednak tym samym co cały system operacyjny. W skład kompletnego systemu wchodzą również między innymi narzędzia systemowe, biblioteki, usługi i elementy interfejsu użytkownika.
4.5. Interfejs użytkownika — jak człowiek komunikuje się z komputerem?
Interfejs użytkownika to sposób, w jaki człowiek przekazuje polecenia systemowi i odbiera informacje zwrotne.
Współczesne komputery najczęściej wykorzystują graficzny interfejs użytkownika, określany skrótem GUI od Graphical User Interface.
GUI obejmuje elementy takie jak okna, ikony, menu, przyciski, paski narzędzi i wskaźnik myszy. Dzięki nim użytkownik może wykonywać wiele operacji bez konieczności wpisywania poleceń tekstowych.
Przykładowo, aby otworzyć dokument, wystarczy odnaleźć plik i kliknąć jego ikonę. System operacyjny rozpoznaje typ pliku i może uruchomić odpowiednią aplikację.
Nie oznacza to jednak, że interfejs graficzny jest jedynym sposobem obsługi komputera.
4.5.1. Interfejs wiersza poleceń
Wiersz poleceń umożliwia komunikację z komputerem za pomocą tekstowych instrukcji.
W Windows dostępne są między innymi Wiersz polecenia i PowerShell. W systemach Linux powszechnie wykorzystuje się terminale oraz powłoki, takie jak Bash.
Dla początkującego użytkownika tekstowy interfejs może wydawać się mniej intuicyjny. W wielu zadaniach okazuje się jednak bardzo wydajny.
Za pomocą poleceń można między innymi przeglądać katalogi, kopiować pliki, uruchamiać programy, analizować działanie systemu i automatyzować powtarzalne czynności.
Przykładowo w wielu powłokach systemów Linux polecenie:
pwd
wyświetla ścieżkę bieżącego katalogu.
Polecenie:
ls
pokazuje zawartość katalogu w typowej konfiguracji systemu Linux.
W PowerShell podobne zadania można wykonywać przy użyciu poleceń:
Get-Location
oraz:
Get-ChildItem
Polecenia mogą się różnić w zależności od systemu, powłoki i konfiguracji. Przed wykonaniem instrukcji znalezionej w internecie warto sprawdzić, co dokładnie robi, szczególnie jeśli wymaga uprawnień administratora.
W pracy programisty i administratora systemów umiejętność korzystania z wiersza poleceń bywa bardzo cenna.
4.6. Procesy i wielozadaniowość
Współczesne systemy operacyjne umożliwiają jednoczesne korzystanie z wielu aplikacji.
Możemy mieć otwartą przeglądarkę, edytor tekstu, odtwarzacz muzyki i komunikator, a wszystkie te programy mogą działać w tym samym czasie.
System operacyjny zarządza ich wykonywaniem za pomocą mechanizmów procesów i wątków.
Proces to działający program wraz z przydzielonym mu środowiskiem i zasobami. Wątek jest jednostką wykonywania instrukcji w ramach procesu. Jeden proces może mieć wiele wątków.
Procesor ma ograniczoną liczbę rdzeni, dlatego system musi rozdzielać czas ich pracy pomiędzy różne zadania. W wielu przypadkach przełączanie odbywa się tak szybko, że użytkownik ma wrażenie, iż wszystkie programy działają jednocześnie.
Na komputerach z wielordzeniowymi procesorami różne wątki mogą również wykonywać się równolegle na różnych rdzeniach.
System operacyjny dba przy tym o to, aby aplikacje nie zajmowały nieograniczonej ilości zasobów i nie zakłócały bez potrzeby działania pozostałych procesów.
4.6.1. Dlaczego komputer czasami zwalnia?
Jeżeli uruchomimy zbyt wiele wymagających aplikacji, system może zacząć działać wolniej.
Przyczyną może być przeciążenie procesora, zbyt mała ilość pamięci RAM, intensywna praca dysku lub ograniczenia termiczne sprzętu.
Niektóre programy wykonują również zadania w tle, nawet jeśli ich okno nie jest aktualnie widoczne.
W takich sytuacjach pomocne może być sprawdzenie wykorzystania zasobów za pomocą narzędzi systemowych. W Windows można wykorzystać Menedżer zadań, a w wielu dystrybucjach Linuxa dostępne są zarówno narzędzia graficzne, jak i tekstowe.
Zamykanie wszystkich procesów, których nazwy są nieznane, nie jest jednak dobrym rozwiązaniem. Niektóre z nich są niezbędne do prawidłowego działania systemu.
Lepiej najpierw ustalić, który proces obciąża komputer i jakie pełni funkcje.
4.7. System plików — porządek w cyfrowym świecie
Komputer przechowuje ogromne ilości danych. Aby można było je odnajdywać, zapisywać i organizować, potrzebny jest system plików.
System plików określa sposób zapisywania i odczytywania plików oraz zarządzania ich strukturą na nośniku danych.
Plik może zawierać dokument tekstowy, zdjęcie, film, program, archiwum lub inny rodzaj informacji. Katalogi, nazywane również folderami, umożliwiają grupowanie plików w uporządkowaną strukturę.
Przykładowa organizacja dokumentów może wyglądać następująco:
Dokumenty
├── Książka
│ ├── Rozdział_1.docx
│ ├── Rozdział_2.docx
│ └── Rozdział_3.docx
├── Zdjęcia
└── Notatki
Taki podział pozwala łatwiej odnajdywać materiały i utrzymywać porządek w projekcie.
4.7.1. Rozszerzenia plików
W wielu systemach pliki mają rozszerzenia, czyli końcówki nazw, które wskazują typ lub format danych.
Przykłady:
— .txt — zwykły tekst;
— .docx — dokument programu Microsoft Word lub zgodnego edytora;
— .pdf — dokument w formacie PDF;
— .jpg — obraz zapisany w formacie JPEG;
— .png — obraz w formacie PNG;
— .mp3 — plik dźwiękowy;
— .py — plik z kodem źródłowym Pythona;
— .zip — archiwum zawierające skompresowane lub zebrane pliki.
Rozszerzenie nie gwarantuje, że plik rzeczywiście zawiera dane zgodne z deklarowanym formatem. Nazwę pliku można zmienić bez konwersji jego zawartości.
Dlatego samo przemianowanie pliku z jednego rozszerzenia na inne nie jest prawidłowym sposobem konwersji dokumentu.
4.7.2. Ścieżki do plików
Systemy operacyjne wykorzystują ścieżki, które określają położenie plików w strukturze katalogów.
W systemie Windows ścieżka może wyglądać następująco:
C:\Users\Użytkownik\Documents\Projekt
W systemach Linux często spotyka się zapis podobny do:
/home/uzytkownik/projekt
Ścieżka pomaga systemowi i użytkownikowi jednoznacznie określić lokalizację danych.
Jest to szczególnie ważne podczas programowania, automatyzacji zadań i pracy z narzędziami AI, które często wymagają wskazania konkretnych plików lub katalogów.
4.8. Sterowniki — połączenie systemu ze sprzętem
Komputer może korzystać z wielu urządzeń: drukarek, kart graficznych, kamer, kontrolerów dźwięku i adapterów sieciowych.
Aby system operacyjny mógł prawidłowo współpracować z określonym urządzeniem, często potrzebuje sterownika.
Sterownik to oprogramowanie umożliwiające systemowi komunikację ze sprzętem lub udostępniające jego funkcje w określony sposób.
Przykładowo sterownik karty graficznej pozwala systemowi i aplikacjom korzystać z funkcji układu graficznego. Sterownik drukarki może udostępniać funkcje potrzebne do przesyłania dokumentów do urządzenia.
W wielu przypadkach podstawowe sterowniki są dostarczane razem z systemem operacyjnym. Inne można zainstalować z oficjalnej strony producenta lub za pomocą mechanizmów aktualizacji systemu.
4.8.1. Dlaczego aktualizacje sterowników są ważne?
Aktualizacje mogą poprawiać stabilność, zgodność, bezpieczeństwo i wydajność urządzeń. Bywa również, że rozwiązują problemy z określonymi aplikacjami.
Nie oznacza to jednak, że każda najnowsza wersja będzie najlepsza w każdej konfiguracji. W środowiskach profesjonalnych aktualizacje czasami testuje się przed wdrożeniem, aby ograniczyć ryzyko problemów.
Sterowniki należy pobierać z zaufanych źródeł, najlepiej od producenta urządzenia lub komputera. Przypadkowe programy obiecujące automatyczne aktualizowanie wszystkich sterowników mogą być niepotrzebne lub ryzykowne.
4.9. Aplikacje — programy, których używamy na co dzień
Aplikacja to program lub zestaw programów przeznaczonych do wykonywania określonych zadań.
Niektóre aplikacje są proste i realizują jedną funkcję. Inne to rozbudowane systemy obejmujące wiele modułów, usług i mechanizmów współpracy.
Przykłady aplikacji obejmują:
— edytory tekstu;
— przeglądarki internetowe;
— programy graficzne;
— narzędzia do montażu wideo;
— aplikacje komunikacyjne;
— programy księgowe;
— środowiska programistyczne;
— gry komputerowe;
— narzędzia wykorzystujące sztuczną inteligencję.
Aplikacje mogą być instalowane lokalnie, działać w przeglądarce internetowej albo korzystać z połączenia obu modeli.
Program lokalny wykonuje znaczną część pracy na urządzeniu użytkownika. Aplikacja internetowa może natomiast polegać na serwerach, które przetwarzają dane i zwracają wyniki do przeglądarki.
W praktyce wiele współczesnych aplikacji łączy elementy lokalne i zdalne.
4.9.1. Instalowanie oprogramowania
Instalacja programu polega na przygotowaniu go do działania w określonym systemie.
W zależności od aplikacji proces może obejmować skopiowanie plików, dodanie ustawień, zainstalowanie bibliotek i utworzenie skrótów.
W Windows często wykorzystuje się instalatory lub sklepy z aplikacjami. W dystrybucjach Linuxa powszechne są menedżery pakietów, a na urządzeniach mobilnych — oficjalne sklepy z aplikacjami.
Przed instalacją programu warto sprawdzić jego pochodzenie, wymagania sprzętowe, warunki licencji i uprawnienia, których wymaga.
Szczególną ostrożność należy zachować wobec nieznanych plików instalacyjnych oraz programów obiecujących funkcje, których wiarygodność trudno potwierdzić.
4.10. Oprogramowanie otwarte i zamknięte
Programy różnią się nie tylko funkcjami, ale również sposobem udostępniania i licencjonowania.
Jednym z ważnych rozróżnień jest podział na oprogramowanie o otwartym kodzie źródłowym oraz oprogramowanie o kodzie zamkniętym.
4.10.1. Oprogramowanie open source
Oprogramowanie open source udostępnia kod źródłowy na warunkach licencji pozwalającej na określone formy jego wykorzystania, analizy i modyfikacji.
Zakres uprawnień zależy od konkretnej licencji. Nie oznacza to, że każdy może dowolnie robić z programem wszystko, bez żadnych obowiązków.
Do znanych przykładów oprogramowania open source należą system operacyjny Linux, przeglądarka Firefox i pakiet biurowy LibreOffice.
Otwarty kod źródłowy może ułatwiać naukę, audyt bezpieczeństwa i rozwój oprogramowania przez społeczności programistów.
4.10.2. Oprogramowanie o kodzie zamkniętym
W przypadku oprogramowania o kodzie zamkniętym użytkownik zazwyczaj nie otrzymuje pełnego kodu źródłowego i może korzystać z programu zgodnie z warunkami określonymi przez właściciela praw.
Przykładami znanych produktów należących do tej kategorii są Microsoft Windows i Adobe Photoshop.
Model zamknięty może umożliwiać producentowi centralne zarządzanie rozwojem produktu, jego dystrybucją i wsparciem technicznym.
Nie można jednak uznać, że jeden model jest zawsze lepszy od drugiego. Wybór zależy od wymagań projektu, budżetu, licencji, bezpieczeństwa, dostępności wsparcia i innych czynników.
4.11. Aktualizacje i bezpieczeństwo systemu
System operacyjny oraz aplikacje wymagają aktualizacji.
Aktualizacje mogą usuwać błędy, poprawiać wydajność, dodawać nowe funkcje i naprawiać luki bezpieczeństwa. Niektóre poprawki są szczególnie ważne, ponieważ ograniczają możliwość wykorzystania znanych podatności przez osoby atakujące.
Nieaktualne oprogramowanie może stanowić poważne zagrożenie, zwłaszcza gdy jest połączone z internetem lub przechowuje ważne dane.
4.11.1. Dlaczego nie warto ignorować aktualizacji?
Wyobraźmy sobie, że w programie zostaje wykryty błąd pozwalający na nieautoryzowany dostęp do określonych informacji. Producent przygotowuje poprawkę, ale użytkownik jej nie instaluje.
Jeśli ktoś wykorzysta tę lukę, komputer może być narażony na atak, któremu można było zapobiec przez aktualizację.
Nie każda aktualizacja przebiega bezproblemowo. Zdarza się, że nowa wersja powoduje konflikt z określonym oprogramowaniem lub sterownikiem. W systemach krytycznych aktualizacje często wdraża się po testach, z przygotowanym planem przywrócenia działania.
W przypadku komputera domowego dobrym rozwiązaniem jest regularne instalowanie aktualizacji pochodzących z oficjalnych kanałów oraz utrzymywanie aktualnych kopii zapasowych ważnych plików.
4.11.2. Koniec wsparcia technicznego
System operacyjny może w pewnym momencie przestać otrzymywać regularne aktualizacje bezpieczeństwa.
W takiej sytuacji dalsze korzystanie z urządzenia może wiązać się ze zwiększonym ryzykiem, szczególnie jeśli komputer służy do bankowości, pracy z poufnymi informacjami lub codziennego przeglądania internetu.
Przykładowo standardowe wsparcie dla Windows 10 zakończyło się 14 października 2025 roku. Istnieją odrębne programy rozszerzonych aktualizacji bezpieczeństwa dla kwalifikujących się urządzeń, ale ich dostępność i warunki zależą od programu oraz rodzaju użytkownika.
Dlatego przed podjęciem decyzji o dalszym korzystaniu ze starszego systemu warto sprawdzić aktualne informacje producenta dotyczące wsparcia, możliwości aktualizacji i wymagań sprzętowych.
4.12. Wirtualizacja — komputer w komputerze
Wirtualizacja to technologia pozwalająca tworzyć środowiska, które zachowują się jak oddzielne komputery, choć korzystają z zasobów jednej fizycznej maszyny.
Takie środowisko nazywamy maszyną wirtualną.
Maszyna wirtualna może mieć własny system operacyjny, dysk wirtualny, przydzieloną pamięć i określoną liczbę wirtualnych procesorów. Jej zasoby są obsługiwane przez oprogramowanie wirtualizacyjne oraz sprzęt komputera gospodarza.
Przykładowo użytkownik może mieć komputer z Windows i uruchomić na nim maszynę wirtualną z Linuksem. Pozwala to testować programy, uczyć się administracji systemami lub sprawdzać działanie oprogramowania w innym środowisku.
Wirtualizacja jest szeroko wykorzystywana w centrach danych i chmurze obliczeniowej. Pozwala uruchamiać wiele odizolowanych środowisk na wspólnym sprzęcie, choć wymaga odpowiedniego zarządzania zasobami i bezpieczeństwem.
Nie należy jednak zakładać, że maszyna wirtualna jest całkowicie odizolowana od komputera gospodarza. Bezpieczeństwo zależy również od konfiguracji, aktualizacji i zastosowanych mechanizmów ochrony.
4.13. Kontenery — lekkie środowiska uruchamiania aplikacji
Kontenery są kolejną technologią wykorzystywaną do uruchamiania oprogramowania w uporządkowanych, odizolowanych środowiskach.
W przeciwieństwie do typowej maszyny wirtualnej kontener zazwyczaj nie zawiera pełnego, osobnego jądra systemu operacyjnego. Korzysta z mechanizmów jądra systemu gospodarza, a jednocześnie izoluje aplikację i jej środowisko w określonym zakresie.
Kontenery pozwalają pakować aplikacje wraz z wieloma zależnościami, co ułatwia ich uruchamianie na różnych środowiskach zgodnych z daną technologią.
Przykładowo programista może przygotować aplikację internetową w kontenerze, a następnie uruchomić ją na komputerze lokalnym, serwerze testowym i infrastrukturze produkcyjnej.
Popularnym narzędziem wykorzystywanym do pracy z kontenerami jest Docker.
Kontenery są istotne w nowoczesnym IT, ponieważ ułatwiają wdrażanie, skalowanie i zarządzanie aplikacjami. Korzystają z nich również zespoły rozwijające usługi oparte na sztucznej inteligencji.
4.14. Oprogramowanie a sztuczna inteligencja
Sztuczna inteligencja nie jest pojedynczym programem ani jednym uniwersalnym algorytmem. To szeroki obszar obejmujący różne metody, modele, biblioteki i narzędzia.
Aby system AI mógł działać, potrzebuje oprogramowania odpowiedzialnego za przetwarzanie danych, wykonywanie obliczeń, komunikację z użytkownikiem i kontrolowanie całego procesu.
W zależności od rozwiązania mogą być wykorzystywane języki programowania, biblioteki do obliczeń numerycznych, systemy baz danych, serwery i specjalistyczne akceleratory sprzętowe.
4.14.1. Model AI a aplikacja AI
Warto rozróżnić model sztucznej inteligencji od aplikacji, która z niego korzysta.
Model jest elementem realizującym określone zadanie na podstawie wytrenowanych parametrów i danych wejściowych. Aplikacja zapewnia natomiast interfejs, zarządzanie danymi, logikę działania i sposób komunikacji z modelem.
Przykładowo model językowy może generować odpowiedzi na pytania, ale pełna aplikacja musi również odebrać wiadomość użytkownika, przekazać ją do modelu, obsłużyć wynik i zaprezentować odpowiedź.
W bardziej rozbudowanych systemach dochodzą mechanizmy zarządzania dostępem, zapisywania historii, pobierania danych z zewnętrznych źródeł oraz kontrolowania kosztów.
Oznacza to, że stworzenie użytecznej aplikacji AI wymaga często połączenia wiedzy o programowaniu, bazach danych, sieciach, bezpieczeństwie i samych modelach.
4.14.2. AI lokalna i AI w chmurze
Modele sztucznej inteligencji mogą działać lokalnie, bezpośrednio na komputerze użytkownika, albo być udostępniane przez zdalną usługę.
Rozwiązanie lokalne daje większą kontrolę nad środowiskiem i może ograniczać konieczność wysyłania danych do zewnętrznego dostawcy. Wymaga jednak odpowiedniego sprzętu, miejsca na dysku i konfiguracji oprogramowania.
Rozwiązanie chmurowe pozwala korzystać z modeli utrzymywanych na serwerach dostawcy. Może zapewniać dostęp do bardzo wydajnej infrastruktury, ale często wiąże się z kosztami, zależnością od połączenia internetowego i koniecznością oceny zasad przetwarzania danych.
Nie istnieje jedna metoda najlepsza w każdej sytuacji. Wybór zależy od rozmiaru modelu, rodzaju zadania, dostępnego sprzętu, wymagań dotyczących prywatności i budżetu.
4.15. Oprogramowanie a rzeczywistość wirtualna
Rzeczywistość wirtualna, czyli VR, wymaga współpracy wielu elementów sprzętowych i programowych.
Gogle prezentują obraz, czujniki rejestrują ruch, a aplikacja oblicza, jak powinno wyglądać wirtualne otoczenie z perspektywy użytkownika.
Oprogramowanie VR musi uwzględniać położenie głowy, ruch kontrolerów, interakcje z obiektami i parametry urządzenia. W wielu zastosowaniach ważne jest również utrzymanie płynnego obrazu oraz ograniczenie opóźnień.
Twórcy aplikacji wykorzystują silniki graficzne, biblioteki, interfejsy programistyczne i narzędzia do projektowania przestrzeni trójwymiarowej.
Dzięki nim mogą tworzyć symulatory, gry, wirtualne szkolenia i środowiska edukacyjne.
Sztuczna inteligencja dodatkowo rozszerza możliwości VR. Może wspierać rozpoznawanie gestów, sterowanie zachowaniem wirtualnych postaci, generowanie treści i dostosowywanie scenariuszy do użytkownika.
Przykładowo szkolenie VR może wykorzystywać wirtualnego instruktora, który odpowiada na pytania i pomaga użytkownikowi przejść przez kolejne etapy zadania.
Takie zastosowania pokazują, że przyszłość oprogramowania nie ogranicza się do tradycyjnych okien i ikon. Coraz częściej będziemy korzystać z systemów reagujących na głos, ruch i kontekst działania.
4.16. Jak świadomie wybierać oprogramowanie?
Wybór programu powinien zależeć od rzeczywistych potrzeb użytkownika, a nie wyłącznie od popularności produktu lub reklamy.
Przed instalacją warto odpowiedzieć sobie na kilka pytań:
1. Jakie zadanie ma wykonywać program?
Należy określić, czy potrzebujemy prostego narzędzia, czy rozbudowanego rozwiązania profesjonalnego.
2. Czy program działa na moim systemie?
Trzeba sprawdzić wymagania dotyczące systemu operacyjnego, procesora, pamięci i innych komponentów.
3. Ile kosztuje korzystanie z programu?
Warto sprawdzić, czy produkt jest bezpłatny, płatny jednorazowo, czy działa w modelu subskrypcyjnym.
4. Jakie dane przetwarza?
Szczególnie ważne jest to w przypadku usług internetowych i narzędzi AI, które mogą otrzymywać dokumenty, obrazy lub informacje osobiste.
5. Czy program jest rozwijany i aktualizowany?
Regularne aktualizacje i dostępne wsparcie mogą mieć znaczenie dla bezpieczeństwa oraz długoterminowego użytkowania.
6. Czy można łatwo przenieść dane do innego rozwiązania?
Otwarte formaty i możliwość eksportu danych mogą ograniczyć zależność od jednego dostawcy.
7. Czy program pochodzi z zaufanego źródła?
Oprogramowanie najlepiej pobierać z oficjalnej strony producenta lub zaufanego repozytorium.
Świadomy wybór oprogramowania pozwala ograniczyć koszty, poprawić bezpieczeństwo i uniknąć problemów wynikających z niezgodności technicznych.
4.17. Podsumowanie rozdziału
System operacyjny i oprogramowanie stanowią podstawę codziennej pracy z komputerem.
System operacyjny zarządza zasobami urządzenia, obsługuje procesy, kontroluje dostęp do plików i udostępnia aplikacjom usługi potrzebne do wykonywania zadań.
Windows, macOS i Linux są przykładami systemów stosowanych na komputerach osobistych i w środowiskach profesjonalnych. Android i iOS pełnią podobną rolę w urządzeniach mobilnych, choć zostały zaprojektowane z myślą o innych warunkach użytkowania.
Jądro systemu odpowiada za wiele podstawowych mechanizmów, natomiast interfejs użytkownika umożliwia wygodną komunikację z komputerem. Procesy i wątki pozwalają organizować wykonywanie programów, a system plików zapewnia strukturę do przechowywania danych.
Sterowniki ułatwiają współpracę systemu ze sprzętem. Aktualizacje pomagają utrzymywać bezpieczeństwo, a wirtualizacja i kontenery pozwalają tworzyć elastyczne środowiska uruchamiania aplikacji.
Oprogramowanie odgrywa również kluczową rolę w rozwoju sztucznej inteligencji i rzeczywistości wirtualnej. To dzięki niemu modele AI mogą analizować dane, a aplikacje VR tworzyć interaktywne światy.
Najważniejszy wniosek jest prosty: sprzęt dostarcza możliwości obliczeniowe, ale to oprogramowanie pozwala wykorzystać je do realizacji konkretnych zadań.
Zrozumienie tej zależności stanowi ważny krok w poznawaniu informatyki. Przygotowuje nas również do kolejnego tematu, czyli programowania — dziedziny, która pozwala tworzyć własne narzędzia, aplikacje i rozwiązania technologiczne.
W następnym rozdziale przyjrzymy się temu, jak powstają programy, w jaki sposób komputer interpretuje instrukcje oraz jak rozpocząć własną przygodę z kodowaniem.
Rozdział 5. Programowanie — język technologii
5.1. Czym jest programowanie?
Komputer potrafi wykonywać ogromną liczbę operacji, przetwarzać dane, wyświetlać obrazy, odtwarzać dźwięk i komunikować się z innymi urządzeniami. Nie podejmuje jednak samodzielnie wszystkich decyzji w taki sposób, jak robi to człowiek. Aby wykonał konkretne zadanie, trzeba dostarczyć mu odpowiednie instrukcje.
Tworzeniem takich instrukcji zajmuje się programowanie.
Programowanie to proces projektowania, zapisywania, testowania i rozwijania instrukcji, które komputer może wykonywać. Instrukcje te zapisuje się w językach programowania, takich jak Python, Java, C++, JavaScript czy C#.
Program komputerowy może być bardzo prosty. Może wyświetlać komunikat na ekranie, obliczać sumę dwóch liczb albo pytać użytkownika o imię. Może też być niezwykle rozbudowany i obsługiwać bankowość internetową, systemy przemysłowe, gry komputerowe, modele sztucznej inteligencji czy aplikacje wykorzystywane w medycynie.
Niezależnie od stopnia złożoności, podstawowa zasada pozostaje podobna: program otrzymuje dane, wykonuje określone operacje i zwraca wynik lub realizuje konkretne działanie.
Przykładem może być kalkulator. Użytkownik wprowadza dwie liczby i wybiera działanie. Program pobiera dane, wykonuje obliczenie, a następnie wyświetla rezultat. W bardziej zaawansowanych systemach ten sam schemat może obejmować miliony operacji wykonywanych na dużych zbiorach danych.
Programowanie nie polega wyłącznie na pisaniu kodu. Ważną częścią pracy programisty jest również zrozumienie problemu, zaplanowanie rozwiązania, sprawdzanie poprawności działania i poprawianie błędów.
5.2. Dlaczego programowanie jest tak ważne?
Współczesny świat jest w dużej mierze oparty na oprogramowaniu. Telefony, komputery, samochody, urządzenia medyczne, systemy płatności, sklepy internetowe i usługi chmurowe wykorzystują programy, które kontrolują ich działanie.
Bez programowania nie byłoby większości narzędzi cyfrowych, z których korzystamy każdego dnia.
Programowanie ma szczególne znaczenie w trzech obszarach omawianych w tej książce: IT, sztucznej inteligencji i rzeczywistości wirtualnej.
Programowanie w IT
W branży informatycznej kod wykorzystuje się między innymi do:
— tworzenia aplikacji komputerowych;
— budowania stron internetowych;
— obsługi baz danych;
— zarządzania serwerami;
— automatyzowania powtarzalnych zadań;
— monitorowania infrastruktury;
— rozwijania systemów bezpieczeństwa;
— integrowania różnych usług i urządzeń.
Administrator systemów może napisać skrypt, który automatycznie sprawdzi stan serwerów. Programista może stworzyć aplikację do zarządzania firmą. Inżynier oprogramowania może natomiast projektować rozbudowany system obsługujący miliony użytkowników.
Programowanie w sztucznej inteligencji
Systemy AI również opierają się na oprogramowaniu. Kod służy do przygotowywania danych, trenowania modeli, uruchamiania wnioskowania oraz łączenia modeli z aplikacjami.
W przypadku uczenia maszynowego programista może przygotować dane, wybrać algorytm i przeprowadzić proces trenowania. Następnie tworzy rozwiązanie, które wykorzystuje wytrenowany model do analizowania nowych informacji.
Warto rozróżnić dwie rzeczy: programowanie systemu AI oraz uczenie modelu AI. Programowanie określa między innymi, jak system ma działać i w jaki sposób korzystać z modelu. Trenowanie polega natomiast na dopasowywaniu parametrów modelu na podstawie danych i wybranej metody uczenia.
Programowanie w VR
Rzeczywistość wirtualna wymaga oprogramowania, które tworzy trójwymiarowe środowisko i reaguje na działania użytkownika.
Kod może odpowiadać za:
— poruszanie się postaci;
— fizykę obiektów;
— interakcję z elementami otoczenia;
— obsługę kontrolerów;
— odtwarzanie dźwięku przestrzennego;
— wyświetlanie grafiki;
— komunikację między użytkownikami.
W silnikach gier, takich jak Unity czy Unreal Engine, programowanie pozwala przekształcić statyczną scenę 3D w interaktywne doświadczenie.
Zrozumienie podstaw programowania daje więc możliwość nie tylko korzystania z technologii, ale także jej samodzielnego tworzenia.
5.3. Czym jest język programowania?
Komputer wewnętrznie operuje na danych zapisanych w postaci binarnej. Człowiekowi trudno byłoby jednak tworzyć duże programy, zapisując wszystkie instrukcje bezpośrednio jako ciągi zer i jedynek.
Dlatego opracowano języki programowania, które umożliwiają zapisywanie instrukcji w bardziej czytelnej postaci.
Przykładowo w Pythonie można napisać:
print(„Witaj, świecie!”)
Instrukcja ta powoduje wyświetlenie tekstu:
Witaj, świecie!
Kod jest zrozumiały dla człowieka, ale komputer musi jeszcze przetworzyć go w sposób odpowiedni dla danego środowiska wykonawczego.
Sposób tego przetwarzania zależy od języka. Niektóre języki są kompilowane do kodu maszynowego lub kodu pośredniego. Inne korzystają z interpretera albo środowiska wirtualnego. W praktyce wiele współczesnych języków łączy różne techniki.
Języki programowania różnią się składnią, zastosowaniami i sposobem działania. Nie istnieje jeden język najlepszy do wszystkich zadań.
Python
Python jest często polecany osobom rozpoczynającym naukę programowania. Ma stosunkowo czytelną składnię i szeroki ekosystem bibliotek.
Wykorzystuje się go w:
— analizie danych;
— automatyzacji;
— tworzeniu narzędzi;
— uczeniu maszynowym;
— sztucznej inteligencji;
— aplikacjach internetowych;
— nauce i badaniach.
W tej książce Python będzie podstawowym językiem ćwiczeń, ponieważ pozwala stosunkowo szybko przejść od prostych instrukcji do praktycznych projektów.
JavaScript
JavaScript jest szczególnie ważny w tworzeniu stron internetowych i aplikacji działających w przeglądarkach. W połączeniu z odpowiednimi środowiskami może być również używany po stronie serwera.
C i C++
C oraz C++ są wykorzystywane między innymi w oprogramowaniu systemowym, silnikach gier, aplikacjach wymagających wysokiej wydajności i rozwiązaniach, w których istotna jest kontrola nad zasobami komputera.
C#
C# jest popularny w tworzeniu aplikacji dla platformy. NET oraz w projektach wykorzystujących silnik Unity. Dzięki temu może być przydatny osobom zainteresowanym tworzeniem gier i aplikacji VR.
Java
Java znajduje zastosowanie w aplikacjach biznesowych, systemach serwerowych i wielu innych rozwiązaniach. Jest również istotna w części ekosystemu aplikacji mobilnych.
Wybór języka powinien wynikać przede wszystkim z celu projektu. Na początek ważniejsze od poznania wielu języków jest zrozumienie podstawowych koncepcji programowania.
5.4. Pierwszy program w Pythonie
Najlepszym sposobem rozpoczęcia nauki jest uruchomienie pierwszego programu.
Przykład:
print(„Witaj w świecie programowania!”)
Funkcja print() służy do wyświetlania informacji. Tekst umieszczony w cudzysłowie jest traktowany jako ciąg znaków.
Po uruchomieniu programu na ekranie pojawi się:
Witaj w świecie programowania!
To niewielki przykład, ale zawiera kilka ważnych elementów.
Po pierwsze, kod musi być zapisany zgodnie z zasadami składni danego języka. Po drugie, program wykonuje określoną instrukcję. Po trzecie, jego działanie można zaobserwować i sprawdzić.
Funkcja print() może również wyświetlać liczby i wyniki obliczeń:
print(10)
print(5 +3)
print(20 — 7)
print(4 * 6)
print(12 / 3)
Wynik:
10
8
13
24
4.0
Python rozpoznaje działania matematyczne i oblicza ich wyniki przed przekazaniem ich do funkcji wyświetlającej.
Podstawowe operatory arytmetyczne to:
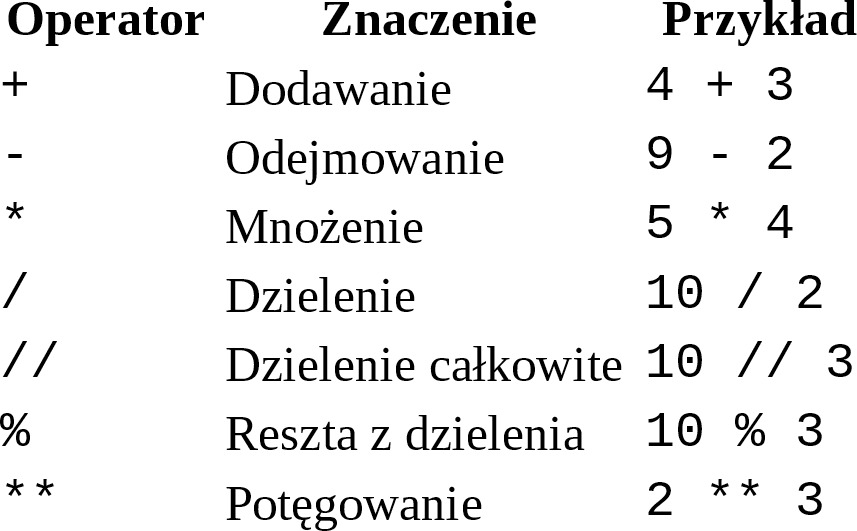
Warto samodzielnie zmieniać liczby w przykładach i sprawdzać wyniki. Eksperymentowanie pomaga zrozumieć, jak program interpretuje poszczególne instrukcje.
5.5. Zmienne — przechowywanie informacji
Programy często muszą zapamiętywać dane, aby wykorzystać je w dalszych obliczeniach.
Do tego celu służą zmienne.
Zmienna jest nazwą, za pomocą której program odwołuje się do przechowywanej wartości. W Pythonie można utworzyć zmienną w następujący sposób:
imie = „Dariusz”
wiek = 30
wzrost = 1.80
print(imie)
print(wiek)
print(wzrost)
W tym przykładzie utworzono trzy zmienne:
— imie przechowuje tekst;
— wiek przechowuje liczbę całkowitą;
— wzrost przechowuje liczbę zmiennoprzecinkową.
Podane wartości są przykładowe. Własny program może przechowywać dowolne dane, które są odpowiednie dla wykonywanego zadania.
Znak = oznacza w tym przypadku przypisanie wartości do zmiennej. Nie jest to dokładnie to samo co matematyczna równość.
Można później zmienić wartość zmiennej:
punkty = 10
print(punkty)
punkty = 15
print(punkty)
Wynik:
10
15
Po pierwszym przypisaniu zmienna punkty ma wartość 10. Następnie jej wartość zostaje zmieniona na 15.
Zmienne umożliwiają tworzenie programów reagujących na zmieniające się dane. Zamiast wpisywać tę samą liczbę w wielu miejscach, można zapisać ją w jednym miejscu i wykorzystywać w całym programie.
Zasady nazywania zmiennych
Nazwy powinny być czytelne i opisywać przechowywane informacje.
Lepszym wyborem jest:
cena_produktu = 49.99
niż:
x = 49.99
Obie wersje są poprawne, ale pierwsza znacznie ułatwia zrozumienie kodu.
W Pythonie nazwy zmiennych nie powinny zaczynać się od cyfry. Nie mogą też zawierać spacji. Do oddzielania słów często stosuje się znak podkreślenia.
Przykładowe poprawne nazwy:
liczba_uzytkownikow = 100
nazwa_pliku = „raport. txt”
czy_zalogowany = True
W Pythonie wielkość liter ma znaczenie. Nazwy wynik, Wynik i WYNIK są traktowane jako różne identyfikatory.
5.6. Typy danych
Dane mogą reprezentować różne rodzaje informacji. Program musi wiedzieć, czy ma do czynienia z liczbą, tekstem czy wartością logiczną.
W Pythonie podstawowe typy danych obejmują:
Liczby całkowite (int)
liczba_osob = 25
Służą do przechowywania liczb całkowitych.
Liczby zmiennoprzecinkowe (float)
temperatura = 21.5
Służą do reprezentowania liczb z częścią ułamkową. Ze względu na sposób zapisu niektóre obliczenia zmiennoprzecinkowe mogą dawać wyniki z niewielkimi różnicami zaokrągleń.
Ciągi znaków (str)
miasto = „Tychy”
Służą do przechowywania tekstu.
Wartości logiczne (bool)
czy_aktywny = True
Mogą przyjmować jedną z dwóch wartości: True albo False.
Typ danych wpływa na to, jakie operacje można wykonywać na wartości i jak program ją interpretuje.
Na przykład dodawanie liczb daje wynik matematyczny:
print(5 +3)
Wynik:
8
Natomiast dodawanie dwóch ciągów znaków może połączyć tekst:
print(„Sztuczna " + „inteligencja”)
Wynik:
Sztuczna inteligencja
Trzeba jednak pamiętać, że tekst i liczba to różne typy danych. Próba bezpośredniego połączenia liczby z tekstem w niektórych operacjach może spowodować błąd. W razie potrzeby można jawnie przekonwertować wartość, na przykład za pomocą str().
wiek = 30
print(„Wiek: " + str(wiek))
Wynik:
Wiek: 30
Zrozumienie typów danych jest szczególnie ważne przy pracy z bazami danych, analizą informacji i sztuczną inteligencją, gdzie błędna interpretacja wartości może prowadzić do nieprawidłowych rezultatów.
5.7. Pobieranie danych od użytkownika
Program staje się bardziej interaktywny, gdy może pobierać informacje od osoby, która go uruchamia.
W Pythonie służy do tego funkcja input().
imie = input(„Jak masz na imię? ”)
print(„Witaj,”, imie)
Po uruchomieniu program wyświetli pytanie. Użytkownik będzie mógł wpisać swoje imię, a następnie program wykorzysta podaną wartość.
Jeżeli użytkownik wpisze Dariusz, rezultat będzie wyglądał następująco:
Jak masz na imię? Dariusz
Witaj, Dariusz
Warto pamiętać, że funkcja input() zwraca tekst. Jeżeli chcemy pobrać liczbę i wykonać na niej obliczenia, trzeba odpowiednio przekonwertować wartość.
Przykład:
wiek = int(input(„Ile masz lat? ”))
print(„Za rok będziesz mieć:”, wiek +1)
Funkcja int() próbuje zamienić podany tekst na liczbę całkowitą. Jeśli użytkownik wpisze wartość, której nie można w ten sposób przekonwertować, program zgłosi błąd.
Można również pobierać liczby z częścią ułamkową:
cena = float(input(„Podaj cenę produktu: ”))
print(„Cena po dodaniu 10 zł:”, cena +10)
W tym prostym przykładzie Python oczekuje standardowego zapisu liczby dziesiętnej z kropką, na przykład 19.99. W programie przeznaczonym dla polskich użytkowników można dodać obsługę przecinka dziesiętnego.
Pobieranie danych jest podstawą wielu aplikacji. Formularze internetowe, kalkulatory, programy księgowe i narzędzia analityczne muszą odbierać informacje, sprawdzać je i przetwarzać.
5.8. Instrukcje warunkowe — podejmowanie decyzji
Programy nie zawsze wykonują te same instrukcje w tej samej kolejności. Często muszą podejmować decyzje w zależności od otrzymanych danych.
W Pythonie służą do tego instrukcje if, elif oraz else.
Przykład:
wiek = int(input(„Podaj swój wiek: ”))
if wiek >= 18:
print(„Jesteś osobą pełnoletnią.”)
else:
print(„Nie masz jeszcze 18 lat.”)
Program sprawdza warunek wiek >= 18.
Jeśli warunek jest prawdziwy, wykona instrukcję znajdującą się po if. Jeśli jest fałszywy, wykona instrukcję po else.
W Pythonie wcięcia mają znaczenie. Pokazują, które instrukcje należą do danego bloku kodu. Nieprawidłowe wcięcia mogą spowodować błąd albo zmienić sposób działania programu.
Można również sprawdzać kilka warunków:
wynik = int(input(„Podaj liczbę punktów: ”))
if wynik >= 90:
print(„Ocena: bardzo dobra”)
elif wynik >= 70:
print(„Ocena: dobra”)
elif wynik >= 50:
print(„Ocena: dostateczna”)
else:
print(„Wynik poniżej progu zaliczenia”)
Program analizuje warunki po kolei. Wykona blok przypisany do pierwszego warunku, który okaże się prawdziwy. Jeżeli żaden z nich nie będzie prawdziwy, wykona blok else.
Instrukcje warunkowe stanowią podstawę logiki wielu systemów.
W aplikacji bankowej mogą służyć do sprawdzania, czy użytkownik ma wystarczające środki. W grze komputerowej mogą decydować o tym, czy postać może otworzyć drzwi. W systemie AI mogą natomiast kierować przepływem działania na podstawie wyniku modelu lub reguł bezpieczeństwa.
Trzeba jednak rozróżnić zwykłą instrukcję warunkową od samej sztucznej inteligencji. Instrukcja if realizuje jawnie zapisany warunek. Model AI może natomiast generować predykcje na podstawie wzorców wyuczonych z danych. W praktycznych aplikacjach obie techniki często współpracują.
5.9. Operatory porównania i logiki
Warunki opierają się na porównywaniu wartości.
Najważniejsze operatory porównania w Pythonie to:
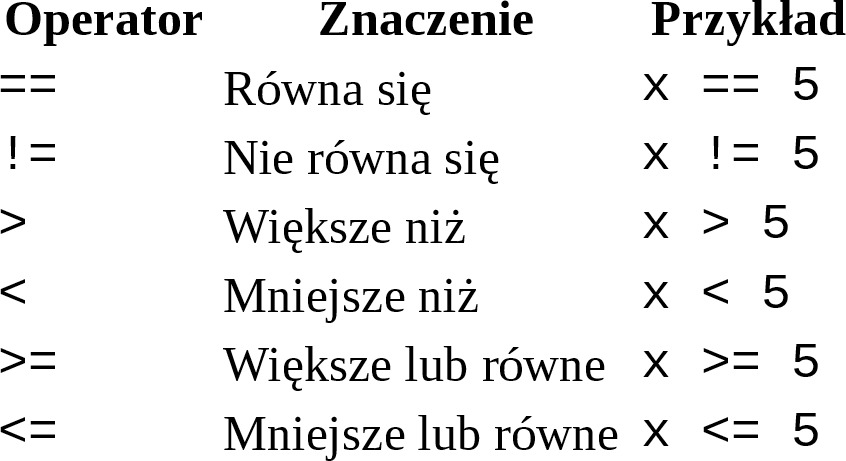
Istotna różnica: = przypisuje wartość, natomiast == porównuje dwie wartości.
Przykład:
liczba = 10
if liczba == 10:
print(„Liczba wynosi 10.”)
Można również łączyć warunki za pomocą operatorów logicznych:
— and — oba warunki muszą być prawdziwe;
— or — wystarczy, że prawdziwy jest co najmniej jeden warunek;
— not — neguje wartość logiczną.
Przykład:
wiek = 25
ma_konto = True
if wiek >= 18 and ma_konto:
print(„Możesz korzystać z usługi.”)
Program wyświetli komunikat tylko wtedy, gdy wiek wynosi co najmniej 18 lat i zmienna ma_konto ma wartość True.
W rzeczywistych systemach warunki mogą być znacznie bardziej rozbudowane. Warto jednak zaczynać od prostych przykładów i stopniowo zwiększać ich złożoność.
5.10. Pętle — automatyczne powtarzanie zadań
Często trzeba wykonać tę samą operację wiele razy. Zamiast wielokrotnie zapisywać podobne instrukcje, można użyć pętli.
Python udostępnia między innymi pętle for oraz while.
Pętla for
Pętla for jest często używana do przechodzenia przez kolejne elementy zbioru lub wykonywania instrukcji określoną liczbę razy.
for i in range(5):
print(„Witaj!”)
Program wyświetli słowo „Witaj!” pięć razy.
Funkcja range(5) generuje kolejno wartości od 0 do 4. Wartość końcowa, czyli 5, nie jest włączana do tego zakresu.
Można wyświetlić również liczby:
for i in range(1, 6):
print(i)
Wynik:
1
2
3
4
5
Pętle są bardzo przydatne przy przetwarzaniu list, analizowaniu danych i automatyzacji powtarzalnych czynności.
Pętla while
Pętla while wykonuje instrukcje tak długo, jak długo określony warunek pozostaje prawdziwy.
licznik = 1
while licznik <= 5:
print(licznik)
licznik += 1
Wynik:
1
2
3
4
5
Instrukcja licznik += 1 zwiększa wartość zmiennej o jeden. Dzięki temu warunek w końcu przestanie być prawdziwy i pętla się zakończy.
Jeżeli warunek nigdy nie stanie się fałszywy, program może wejść w nieskończoną pętlę. Dlatego przy używaniu while trzeba uważać, aby zapewnić możliwość zakończenia działania.
Pętle są powszechne w oprogramowaniu. Mogą służyć do przetwarzania tysięcy rekordów, odczytywania danych, aktualizowania stanu gry czy wykonywania kolejnych etapów obliczeń.
5.11. Listy — przechowywanie wielu wartości
Zmienna może przechowywać pojedynczą wartość, ale często potrzebujemy całego zbioru informacji.
W Pythonie do tego celu można wykorzystać listę.
miasta = [„Tychy”, „Katowice”, „Kraków”, „Warszawa”]
print(miasta)
Lista przechowuje kilka elementów w określonej kolejności.
Do elementów można odwoływać się za pomocą indeksów. W Pythonie pierwszy element ma indeks 0.
miasta = [„Tychy”, „Katowice”, „Kraków”, „Warszawa”]
print(miasta[0])
print(miasta[2])
Wynik:
Tychy
Kraków
Listę można również modyfikować:
miasta = [„Tychy”, „Katowice”]
miasta. append(„Kraków”)
print(miasta)
Metoda append() dodaje nowy element na końcu listy.
Aby przejść przez wszystkie elementy, można wykorzystać pętlę:
miasta = [„Tychy”, „Katowice”, „Kraków”]
for miasto in miasta:
print(miasto)
Takie rozwiązanie jest czytelne i pozwala przetwarzać dowolną liczbę elementów bez ręcznego odwoływania się do każdego z nich.
Listy są ważne w wielu zastosowaniach, od prostych programów po przetwarzanie danych. Przy bardziej złożonych projektach korzysta się również z innych struktur danych, takich jak słowniki, krotki, zbiory czy tablice dostępne w specjalistycznych bibliotekach.
5.12. Funkcje — porządkowanie kodu
Wraz z rozwojem programu liczba instrukcji może szybko rosnąć. Umieszczenie całego kodu w jednym miejscu utrudnia jego czytanie, testowanie i rozwijanie.
Funkcje pozwalają wydzielić fragmenty programu, które realizują określone zadania.
Przykład:
def przywitaj():
print(„Witaj w świecie programowania!”)
przywitaj()
Słowo def rozpoczyna definicję funkcji. Nazwa przywitaj określa, jak będziemy się do niej odwoływać. Instrukcja znajdująca się wewnątrz funkcji jest wykonywana po jej wywołaniu.
Funkcje mogą przyjmować argumenty:
def przywitaj(imie):
print(„Witaj,”, imie)
przywitaj(„Dariusz”)
przywitaj(„Anna”)
Dzięki argumentom jedna funkcja może działać na różnych danych.
Funkcja może również zwracać wynik:
def dodaj(a, b):
return a + b
wynik = dodaj(5, 7)
print(wynik)
Wynik:
12
Instrukcja return przekazuje rezultat wywołania funkcji do miejsca, w którym została ona użyta.
Funkcje ułatwiają ponowne wykorzystanie kodu, zmniejszają liczbę powtórzeń i pomagają dzielić większy problem na mniejsze części.
W rozbudowanych aplikacjach poszczególne funkcje mogą odpowiadać za pobieranie danych, sprawdzanie poprawności, wykonywanie obliczeń i prezentowanie wyników. Takie rozdzielenie odpowiedzialności pomaga utrzymać porządek w projekcie.
5.13. Komentarze i czytelność kodu
Kod powinien być napisany nie tylko tak, aby komputer mógł go wykonać, ale także tak, aby człowiek potrafił go zrozumieć.
W Pythonie komentarze jednowierszowe rozpoczyna się znakiem #.
# Obliczamy całkowity koszt zakupu
cena = 20
ilosc = 3
koszt = cena * ilosc
print(koszt)
Python ignoruje tekst komentarza podczas wykonywania programu.
Komentarze warto wykorzystywać do wyjaśniania intencji lub nietypowych decyzji. Nie ma potrzeby opisywania każdej oczywistej instrukcji. Jeśli kod jest dobrze napisany, jego działanie powinno być w dużej mierze czytelne samo w sobie.
Porównajmy dwa przykłady:
x = 100
y = 5
z = x * y
oraz:
cena_jednostkowa = 100
liczba_sztuk = 5
calkowity_koszt = cena_jednostkowa * liczba_sztuk
Drugi przykład jest bardziej zrozumiały, ponieważ nazwy zmiennych wyjaśniają, co oznaczają przechowywane wartości.
Czytelność nabiera szczególnego znaczenia w dużych zespołach. Kod jest często rozwijany przez wiele osób, a po kilku miesiącach nawet jego autor może nie pamiętać wszystkich szczegółów pierwotnego rozwiązania.
Dobry programista dba więc zarówno o poprawność działania, jak i o jakość kodu.
5.14. Błędy w programowaniu
Błędy są naturalną częścią tworzenia oprogramowania. Nie oznaczają automatycznie, że ktoś nie nadaje się do programowania. Są informacją, że program nie działa zgodnie z oczekiwaniami i trzeba znaleźć przyczynę.
Można wyróżnić kilka podstawowych kategorii błędów.
Błędy składniowe
Powstają wtedy, gdy kod nie spełnia zasad składni języka.
Przykład błędny:
if 5 > 3
print(„Warunek jest prawdziwy”)
Brakuje dwukropka po warunku if. Poprawna wersja:
if 5 > 3:
print(„Warunek jest prawdziwy”)
Błędy wykonania
Występują podczas wykonywania programu.
Przykładem jest próba dzielenia przez zero:
wynik = 10 / 0
Python zgłosi wyjątek, ponieważ taka operacja jest niedozwolona.
Błędy logiczne
Program wykonuje się, ale daje nieprawidłowy wynik.
Przykładowo:
szerokosc = 5
wysokosc = 4
pole = szerokosc + wysokosc
print(pole)
Kod jest składniowo poprawny, ale oblicza sumę boków zamiast pola prostokąta. Właściwe obliczenie wygląda następująco:
szerokosc = 5
wysokosc = 4
pole = szerokosc * wysokosc
print(pole)
Błędy logiczne bywają trudniejsze do znalezienia niż błędy składniowe, ponieważ program może działać bez wyświetlania żadnych komunikatów o problemie.
Debugowanie
Proces wyszukiwania i usuwania błędów nazywa się debugowaniem.
Podstawowe metody debugowania obejmują:
— dokładne czytanie komunikatów o błędach;
— sprawdzanie wartości zmiennych;
— dzielenie problemu na mniejsze części;
— testowanie poszczególnych funkcji;
— korzystanie z debuggera;
— porównywanie rzeczywistych wyników z oczekiwanymi.
Warto nauczyć się analizować komunikaty błędów zamiast od razu usuwać fragment kodu, którego działania się nie rozumie. Komunikat często wskazuje rodzaj problemu i miejsce, w którym został wykryty.
5.15. Testowanie programów
Samo uruchomienie programu jeden raz nie daje pewności, że działa on poprawnie w każdej sytuacji.
Testowanie polega na sprawdzaniu, czy program zachowuje się zgodnie z wymaganiami.
Załóżmy, że tworzymy funkcję obliczającą sumę dwóch liczb:
def dodaj(a, b):
return a + b
Możemy sprawdzić jej działanie:
print(dodaj(2, 3))
print(dodaj(-2, 2))
print(dodaj(0, 0))
Oczekiwane wyniki to odpowiednio 5, 0 i 0.
Warto testować nie tylko typowe dane, ale także przypadki brzegowe, na przykład wartości zerowe, liczby ujemne czy bardzo duże wartości. W programach przetwarzających tekst należy sprawdzić również pusty tekst i nieoczekiwane znaki.
W większych projektach stosuje się testy automatyczne. Program może samodzielnie sprawdzać, czy wybrane funkcje zwracają oczekiwane wyniki. Pozwala to szybciej wykrywać problemy po wprowadzeniu zmian.
Testowanie jest szczególnie ważne w systemach finansowych, medycznych, przemysłowych oraz wszędzie tam, gdzie błędne działanie może powodować poważne konsekwencje.
5.16. Jak przygotować środowisko do nauki Pythona?
Aby rozpocząć naukę, potrzebujesz środowiska, w którym można pisać i uruchamiać kod.
Najprostsza droga to zainstalowanie Pythona i korzystanie z edytora kodu. Można również użyć środowiska programistycznego, które integruje edytowanie, uruchamianie i debugowanie programów.
Krok 1. Zainstaluj Pythona
Pobierz instalator z oficjalnej strony:
Python: https://www.python.org/downloads/
Wybierz wersję odpowiednią dla swojego systemu operacyjnego. Podczas instalacji w systemie Windows warto zaznaczyć opcję dodania Pythona do zmiennej środowiskowej PATH, jeśli instalator udostępnia taką możliwość.
Krok 2. Wybierz edytor
Kod można zapisywać w zwykłym edytorze tekstu, ale wygodniej korzystać z narzędzia przeznaczonego do programowania.
Popularnym wyborem jest Visual Studio Code:
Visual Studio Code: https://code.visualstudio.com/
Po instalacji można dodać rozszerzenie obsługujące Pythona. Edytor pomaga rozpoznawać składnię, porządkuje kod i ułatwia uruchamianie programów.
Krok 3. Utwórz pierwszy plik
Utwórz plik o nazwie:
pierwszy_program.py
Rozszerzenie. py jest standardowo używane dla plików źródłowych Pythona.
Wpisz do pliku:
print(„Mój pierwszy program w Pythonie”)
Zapisz plik.
Krok 4. Uruchom program
W systemie Windows otwórz terminal lub wiersz polecenia, przejdź do katalogu zawierającego plik i wpisz:
python pierwszy_program.py
Na niektórych instalacjach Windows należy użyć polecenia:
py pierwszy_program.py
Jeżeli Python jest prawidłowo zainstalowany i dostępny w środowisku, program wyświetli:
Mój pierwszy program w Pythonie
Jeśli polecenie nie zostanie rozpoznane, sprawdź instalację i sposób dodania Pythona do ścieżki systemowej. Można również uruchomić plik bezpośrednio z odpowiednio skonfigurowanego edytora.
Na tym etapie nie trzeba instalować wielu bibliotek. Wystarczy sam Python i możliwość uruchamiania prostych skryptów.
5.17. Praktyczny projekt 1 — prosty kalkulator
Pierwszym projektem będzie kalkulator wykonujący cztery podstawowe działania matematyczne.
Program powinien:
— pobrać dwie liczby;
— wykonać dodawanie, odejmowanie, mnożenie i dzielenie;
— wyświetlić wyniki;
— zabezpieczyć dzielenie przed sytuacją, w której druga liczba wynosi zero.
Kod:
liczba1 = float(input(„Podaj pierwszą liczbę: ”))
liczba2 = float(input(„Podaj drugą liczbę: ”))
print(„Dodawanie:”, liczba1 + liczba2)
print(„Odejmowanie:”, liczba1 — liczba2)
print(„Mnożenie:”, liczba1 * liczba2)
if liczba2!= 0:
print(„Dzielenie:”, liczba1 / liczba2)
else:
print(„Nie można dzielić przez zero.”)
Program korzysta z kilku poznanych wcześniej elementów:
— input() pobiera dane;
— float() zamienia tekst na liczbę zmiennoprzecinkową;
— operatory wykonują obliczenia;
— if sprawdza, czy dzielenie jest dozwolone;
— print() prezentuje wyniki.
Po uruchomieniu warto sprawdzić różne zestawy danych, w tym przypadek, gdy druga liczba wynosi zero.
Możliwe rozszerzenia
Po uruchomieniu podstawowej wersji można rozbudować kalkulator.
Spróbuj dodać:
— wybór jednego działania zamiast wykonywania wszystkich;
— obsługę nieprawidłowo wprowadzonych danych;
— możliwość wykonania kilku obliczeń bez ponownego uruchamiania programu;
— zapisywanie historii obliczeń;
— funkcje odpowiadające za poszczególne działania.
Rozwijanie małego projektu to dobry sposób na utrwalanie wiedzy. Każde rozszerzenie wymaga połączenia kilku podstawowych umiejętności.
5.18. Praktyczny projekt 2 — zgadywanie liczby
Drugim projektem będzie prosta gra, w której komputer losuje liczbę, a użytkownik próbuje ją odgadnąć.
Do losowania wykorzystamy moduł random, który jest częścią standardowej biblioteki Pythona.
import random
sekretna_liczba = random. randint(1, 100)
proba = 0
print(„Zgadnij liczbę od 1 do 100.”)
while True:
odpowiedz = int(input(„Podaj liczbę: ”))
proba += 1
if odpowiedz < sekretna_liczba:
print(„Za mało!”)
elif odpowiedz > sekretna_liczba:
print(„Za dużo!”)
else:
print(„Brawo! Zgadłeś liczbę.”)
print(„Liczba prób:”, proba)
break
W programie pojawiają się nowe elementy.
Instrukcja import random udostępnia funkcje z modułu random. Funkcja randint(1, 100) losuje liczbę całkowitą z podanego zakresu, włącznie z obiema granicami.
Pętla while True powtarza działanie programu, dopóki nie zostanie przerwana. Instrukcja break kończy pętlę po odgadnięciu liczby.
Zmienna proba zlicza liczbę podejść. Instrukcja proba += 1 zwiększa jej wartość o jeden po każdym wpisaniu odpowiedzi.
Ten przykład pokazuje, że nawet krótki program może zawierać losowanie, pobieranie danych, warunki, pętlę i licznik.
Zadania rozszerzające
Spróbuj zmodyfikować grę tak, aby:
— ograniczała liczbę prób;
— informowała, ile prób pozostało;
— pozwalała rozpocząć nową grę;
— obsługiwała sytuację, w której użytkownik wpisze tekst zamiast liczby;
— umożliwiała zmianę zakresu losowania.
Każde z tych zadań wprowadza praktyczny problem, który można rozwiązać za pomocą poznanych już narzędzi.
5.19. Programowanie obiektowe — wprowadzenie
W miarę rozwoju umiejętności warto poznać programowanie obiektowe, znane jako OOP, czyli Object-Oriented Programming.
Programowanie obiektowe pozwala organizować kod wokół obiektów, które łączą dane i operacje na tych danych.
W świecie rzeczywistym możemy opisać samochód za pomocą takich informacji jak marka, model i prędkość. Możemy też określić działania, takie jak przyspieszanie czy hamowanie.
W programie podobne pojęcia można odwzorować za pomocą klasy i obiektu.
Klasa jest definicją określającą strukturę i zachowanie określonego rodzaju obiektów. Obiekt jest konkretną instancją tej klasy.
Prosty przykład w Pythonie:
class Samochod:
def __init__(self, marka):
self.marka = marka
def przedstaw_sie(self):
print(„Marka samochodu:”, self.marka)
moj_samochod = Samochod(„Toyota”)
moj_samochod.przedstaw_sie()
Wynik:
Marka samochodu: Toyota
Metoda __init__() jest wywoływana podczas tworzenia obiektu i służy tutaj do ustawienia jego marki. Parametr self odnosi się do konkretnego obiektu.
W tym przykładzie klasa Samochod opisuje wspólną strukturę, a obiekt moj_samochod reprezentuje konkretny samochód.
Programowanie obiektowe jest stosowane w wielu większych aplikacjach, systemach biznesowych i projektach gier. Pomaga organizować złożony kod, choć nie każdy problem wymaga użycia klas. Wybór podejścia powinien zależeć od charakteru projektu.
W tworzeniu gier i aplikacji VR obiekty mogą reprezentować postacie, drzwi, przedmioty, urządzenia i elementy środowiska. W systemach biznesowych mogą natomiast reprezentować użytkowników, zamówienia, dokumenty lub produkty.
5.20. Algorytmy — plan działania programu
Programowanie nie zaczyna się od napisania pierwszej linijki kodu. Najpierw trzeba zrozumieć problem i ustalić, jakie działania doprowadzą do rozwiązania.
Uporządkowany zestaw kroków prowadzących do osiągnięcia celu nazywamy algorytmem.
Algorytm może być opisany słownie, przedstawiony w postaci schematu blokowego albo zapisany jako pseudokod. Dopiero później można przełożyć go na konkretny język programowania.
Rozważmy przykład obliczania średniej z trzech liczb.
Plan działania:
— Pobierz pierwszą liczbę.
— Pobierz drugą liczbę.
— Pobierz trzecią liczbę.
— Dodaj wszystkie liczby.
— Podziel sumę przez trzy.
— Wyświetl wynik.
Taki plan można zapisać w Pythonie:
a = float(input(„Podaj pierwszą liczbę: ”))
b = float(input(„Podaj drugą liczbę: ”))
c = float(input(„Podaj trzecią liczbę: ”))
srednia = (a + b + c) / 3
print(„Średnia:”, srednia)
Program realizuje algorytm krok po kroku.
Przy prostych zadaniach plan może wydawać się zbędny. Przy większych projektach staje się jednak bardzo ważny, ponieważ pomaga ustalić wymagania, rozpoznać trudne przypadki i uniknąć niepotrzebnego komplikowania kodu.
Algorytmy stanowią również podstawę wielu metod sztucznej inteligencji. Algorytm uczenia maszynowego określa sposób dopasowywania modelu do danych, a algorytmy wyszukiwania mogą pomagać w odnajdywaniu informacji lub planowaniu działań.
Nie każdy algorytm jest sztuczną inteligencją. Algorytm to ogólna metoda rozwiązywania problemu, a AI obejmuje określone podejścia do wykonywania zadań wymagających między innymi rozpoznawania wzorców, przewidywania lub podejmowania decyzji.
5.21. Programowanie a sztuczna inteligencja
Wraz z rozwojem AI zmienia się sposób, w jaki ludzie tworzą oprogramowanie. Modele generatywne potrafią pomagać w pisaniu kodu, wyjaśnianiu błędów, tworzeniu testów i proponowaniu sposobów rozwiązania problemów.
Nie oznacza to jednak, że znajomość programowania przestała być potrzebna.
Aby odpowiedzialnie korzystać z narzędzi AI, warto rozumieć:
— co kod ma robić;
— jakie dane otrzymuje;
— jakie wyniki powinien zwracać;
— czy wygenerowane rozwiązanie jest poprawne;
— czy program nie ujawnia poufnych danych;
— czy rozwiązanie jest bezpieczne i wydajne.
Model AI może zaproponować kod, który wygląda wiarygodnie, ale zawiera błąd, wykorzystuje nieistniejącą funkcję albo nie uwzględnia ważnego przypadku. Dlatego wynik pracy modelu należy sprawdzać i testować.
Przykład wykorzystania AI
Załóżmy, że chcesz stworzyć program obliczający średnią ocen. Możesz poprosić asystenta AI o przygotowanie pierwszej wersji kodu, a następnie samodzielnie przeanalizować jej działanie.
Warto zadawać konkretne pytania:
— Jak działa ta funkcja?
— Co się stanie, jeśli lista ocen będzie pusta?
— Jak można sprawdzić poprawność danych?
— Jak napisać testy dla tego programu?
— Czy kod można uprościć bez utraty czytelności?
Takie podejście pomaga uczyć się programowania, zamiast jedynie kopiować gotowe rozwiązania.
AI może pełnić rolę pomocnika, ale odpowiedzialność za sprawdzenie programu nadal spoczywa na osobie, która decyduje się go wykorzystać.
Programowanie a uczenie maszynowe
W tradycyjnym programowaniu człowiek zapisuje reguły, które komputer ma wykonywać. W uczeniu maszynowym tworzy się model, którego parametry są dopasowywane na podstawie danych.
Dla przykładu tradycyjny program może sprawdzać, czy temperatura przekracza ustalony próg. Model uczenia maszynowego może natomiast analizować wiele cech urządzenia i na podstawie wcześniejszych obserwacji przewidywać ryzyko awarii.
W obu przypadkach potrzebne jest oprogramowanie. Różnica dotyczy między innymi sposobu uzyskiwania reguł wykorzystywanych do podejmowania decyzji.
Do pracy z uczeniem maszynowym często wykorzystuje się Pythona oraz biblioteki takie jak NumPy, pandas, scikit-learn, PyTorch czy TensorFlow. Szczegóły ich działania omówimy w kolejnych rozdziałach poświęconych sztucznej inteligencji.
5.22. Programowanie a rzeczywistość wirtualna
Tworzenie środowisk VR łączy programowanie, grafikę komputerową, dźwięk, fizykę i projektowanie interakcji.
Samo przygotowanie trójwymiarowego modelu nie wystarczy, aby powstało w pełni interaktywne doświadczenie. Trzeba jeszcze określić, jak użytkownik będzie się poruszał, jak obiekty będą reagowały na jego działania i co będzie się działo po wykonaniu określonej czynności.
W grze VR można na przykład zaprogramować drzwi, które otwierają się po naciśnięciu przycisku na kontrolerze. W aplikacji szkoleniowej można przygotować procedurę, która reaguje na poprawne lub niepoprawne wykonanie zadania.
W takich projektach kod może obsługiwać:
— ruch i położenie obiektów;
— wykrywanie kolizji;
— interakcje z kontrolerami;
— stan aplikacji;
— logikę gry;
— dźwięk i animacje;
— komunikację sieciową;
— zapisywanie postępów użytkownika.
W silniku Unity często wykorzystuje się język C#, natomiast Unreal Engine oferuje między innymi programowanie w C++ oraz wizualny system Blueprint.
Wybór narzędzi zależy od rodzaju projektu, docelowego sprzętu i doświadczenia zespołu.
Podstawy programowania poznane w tym rozdziale ułatwią późniejsze zrozumienie logiki aplikacji VR. Zamiast traktować interaktywny świat jako nieprzejrzysty mechanizm, będzie można analizować go jako zestaw obiektów, danych, zdarzeń i reguł.
5.23. Jak rozwijać umiejętności programistyczne?
Programowania najlepiej uczyć się przez regularną praktykę. Przeczytanie opisu instrukcji if pozwala poznać jej przeznaczenie, ale dopiero samodzielne napisanie kilku programów pomaga zrozumieć, jak wykorzystać ją w różnych sytuacjach.
Dobrym początkiem jest krótka sesja nauki, podczas której realizuje się jedno konkretne zadanie. Może to być napisanie kalkulatora, przygotowanie listy zakupów, stworzenie gry tekstowej lub automatyczne uporządkowanie plików.
Warto stopniowo zwiększać poziom trudności.
Etap pierwszy — podstawy
Naucz się:
— wyświetlać informacje;
— pobierać dane od użytkownika;
— korzystać ze zmiennych;
— rozumieć typy danych;
— wykonywać działania matematyczne;
— używać instrukcji warunkowych;
— tworzyć pętle.
Etap drugi — organizacja kodu
Następnie poznaj:
— funkcje;
— listy i słowniki;
— obsługę błędów;
— pracę z plikami;
— moduły;
— podstawy testowania.
Etap trzeci — małe projekty
Wykorzystaj poznane umiejętności w praktyce. Możesz stworzyć prosty menedżer zadań, program do obliczania wydatków albo aplikację zapisującą informacje w pliku.
Etap czwarty — specjalizacja
Kiedy podstawy staną się zrozumiałe, wybierz kierunek rozwoju.
Jeżeli interesuje Cię automatyzacja i analiza danych, rozwijaj znajomość Pythona. Jeżeli chcesz tworzyć aplikacje internetowe, poznaj HTML, CSS i JavaScript. Jeżeli Twoim celem są gry oraz VR, zainteresuj się silnikami Unity lub Unreal Engine.
W obszarze sztucznej inteligencji warto później poznać podstawy statystyki, algebry liniowej, analizy danych i uczenia maszynowego.
Nie trzeba od razu znać wszystkich technologii. Znacznie skuteczniejsze jest opanowanie podstaw i stopniowe rozwijanie wiedzy w wybranym kierunku.
5.24. Najczęstsze błędy początkujących
Osoby rozpoczynające naukę programowania często napotykają podobne trudności.
Próba zapamiętania wszystkiego
Nie trzeba pamiętać każdej funkcji i składni. Ważniejsze jest zrozumienie podstawowych zasad oraz umiejętność znalezienia wiarygodnej dokumentacji.
Kopiowanie kodu bez zrozumienia
Gotowy przykład może być pomocny, ale warto wiedzieć, dlaczego działa. Dobrym ćwiczeniem jest zmiana kilku elementów kodu i obserwowanie skutków.
Zbyt duże projekty na początek
Próba stworzenia rozbudowanej aplikacji już pierwszego dnia może prowadzić do frustracji. Lepiej rozpocząć od niewielkiego zadania i rozwijać je krok po kroku.
Ignorowanie komunikatów o błędach
Komunikaty błędów zawierają ważne informacje. Należy nauczyć się czytać je uważnie i sprawdzać, gdzie program napotkał problem.
Brak testowania
Program może działać dla jednego zestawu danych, ale nie działać dla innego. Dlatego warto testować różne przypadki i sprawdzać wyniki.
Rezygnacja po pierwszych trudnościach
Programowanie wymaga cierpliwości. Błędy, nieudane próby i konieczność poprawiania kodu są normalnymi elementami pracy.
Postęp nie zawsze jest widoczny po jednej sesji. Z czasem jednak rozwiązania, które początkowo wydawały się skomplikowane, stają się łatwiejsze do zrozumienia.
5.25. Ćwiczenia do samodzielnego wykonania
Poniższe zadania pozwolą sprawdzić, czy podstawowe pojęcia zostały zrozumiane.
Ćwiczenie 1. Powitanie
Napisz program, który pyta użytkownika o imię, a następnie wyświetla spersonalizowane powitanie.
Ćwiczenie 2. Obliczanie wieku
Napisz program, który pobiera rok urodzenia i oblicza przybliżony wiek użytkownika na podstawie bieżącego roku. Pamiętaj, że bez dokładnej daty urodzenia wynik może różnić się o jeden rok.
Ćwiczenie 3. Parzystość liczby
Napisz program, który pobiera liczbę całkowitą i sprawdza, czy jest parzysta. Wykorzystaj operator reszty z dzielenia %.
Ćwiczenie 4. Suma liczb
Użyj pętli, aby obliczyć sumę liczb od 1 do 100.
Ćwiczenie 5. Największa liczba
Utwórz listę zawierającą kilka liczb i napisz program, który znajdzie największą wartość.
Ćwiczenie 6. Funkcja obliczająca pole
Napisz funkcję, która przyjmuje długość i szerokość prostokąta, a następnie zwraca jego pole.
Ćwiczenie 7. Rozbudowa kalkulatora
Zmodyfikuj kalkulator z tego rozdziału tak, aby użytkownik mógł wybrać działanie. Dodaj obsługę dzielenia przez zero oraz nieprawidłowych danych wejściowych.
Ćwiczenie 8. Rozbudowa gry
Dodaj do gry w zgadywanie liczby limit prób. Po wyczerpaniu limitu program powinien wyświetlić komunikat o przegranej i ujawnić wylosowaną liczbę.
Ćwiczenie 9. Analiza danych
Utwórz listę zawierającą kilka ocen. Napisz funkcję, która oblicza średnią i sprawdza, czy lista zawiera jakiekolwiek elementy.
Ćwiczenie 10. Współpraca z AI
Poproś asystenta AI o przygotowanie prostego programu, który zapisuje zadania na liście. Następnie przeanalizuj kod, uruchom go i spróbuj dodać możliwość usuwania zadań.
Celem ćwiczeń nie jest jedynie uzyskanie poprawnego wyniku. Ważne jest również zrozumienie, w jaki sposób program dochodzi do tego wyniku.
5.26. Podsumowanie
Programowanie jest jednym z podstawowych narzędzi współczesnej informatyki. Pozwala tworzyć aplikacje, automatyzować pracę, przetwarzać dane i budować systemy, które wspierają ludzi w codziennych zadaniach.
W tym rozdziale poznaliśmy najważniejsze podstawy:
— czym jest programowanie i do czego służy;
— czym różnią się języki programowania;
— jak napisać i uruchomić pierwszy program w Pythonie;
— jak wykorzystywać zmienne i typy danych;
— jak pobierać dane od użytkownika;
— jak tworzyć instrukcje warunkowe i pętle;
— jak korzystać z list i funkcji;
— jak rozpoznawać błędy i testować kod;
— jak zaplanować prosty algorytm;
— w jaki sposób programowanie łączy się z AI i VR.
Najważniejsza zasada brzmi: programowania najlepiej uczyć się przez tworzenie, testowanie i poprawianie własnych rozwiązań.
Nie trzeba od razu tworzyć zaawansowanych systemów. Wystarczy zacząć od małych programów, zrozumieć ich działanie i stopniowo zwiększać poziom trudności.
W kolejnych rozdziałach przyjrzymy się temu, jak komputery komunikują się ze sobą, jak działa internet i w jaki sposób dane są przesyłane pomiędzy urządzeniami. To wiedza niezbędna do zrozumienia nowoczesnych aplikacji, usług chmurowych oraz systemów sztucznej inteligencji.
Rozdział 6. Internet, sieci komputerowe i chmura
Wprowadzenie
Współczesny świat jest uzależniony od przepływu informacji. Korzystamy z komunikatorów, wyszukiwarek internetowych, bankowości elektronicznej, platform streamingowych, sklepów internetowych i usług przechowywania danych. Wiele osób używa tych technologii każdego dnia, nie zastanawiając się, co właściwie dzieje się w tle.
Wpisanie adresu strony internetowej, wysłanie wiadomości czy uruchomienie aplikacji opartej na sztucznej inteligencji może wydawać się prostą czynnością. W rzeczywistości za każdym z tych działań stoi rozbudowana infrastruktura, obejmująca komputery, serwery, routery, protokoły komunikacyjne, centra danych i oprogramowanie.
Internet nie jest pojedynczym komputerem ani jedną wielką siecią zarządzaną przez jedną firmę. To ogromny system połączonych ze sobą sieci, które współpracują ze sobą zgodnie z określonymi standardami.
Zrozumienie zasad działania internetu jest istotne dla każdego, kto chce rozwijać wiedzę informatyczną. Jest szczególnie ważne w kontekście sztucznej inteligencji i rzeczywistości wirtualnej, ponieważ wiele nowoczesnych rozwiązań technologicznych wykorzystuje zdalne serwery, szybkie połączenia i usługi chmurowe.
W tym rozdziale poznamy podstawy komunikacji sieciowej, sposób działania adresów IP i DNS, rolę routerów i serwerów, najważniejsze protokoły internetowe oraz zasady funkcjonowania chmury obliczeniowej. Na końcu prześledzimy krok po kroku, co dzieje się po wpisaniu adresu strony internetowej w przeglądarce.
6.1. Czym jest internet?
Internet to globalny system połączonych sieci komputerowych, które komunikują się ze sobą przy użyciu wspólnych standardów i protokołów.
Najważniejszym elementem tej komunikacji jest rodzina protokołów TCP/IP. Dzięki niej urządzenia różnych producentów i korzystające z różnych systemów operacyjnych mogą wymieniać dane niezależnie od tego, czy znajdują się w jednym budynku, w różnych miastach, czy na odległych kontynentach.
Komputer z systemem Windows może komunikować się z serwerem działającym pod kontrolą Linuksa. Smartfon może pobierać informacje z centrum danych znajdującego się tysiące kilometrów dalej. Konsola do gier może łączyć się z serwerem obsługującym rozgrywkę wieloosobową.
Wszystkie te urządzenia mogą współpracować dzięki wspólnym zasadom komunikacji.
Krótka historia internetu
Początki internetu wiążą się z rozwojem komputerowych sieci badawczych w drugiej połowie XX wieku.
W 1969 roku uruchomiono ARPANET, eksperymentalną sieć łączącą wybrane ośrodki badawcze w Stanach Zjednoczonych. Był to ważny etap rozwoju technologii umożliwiającej komunikację między komputerami znajdującymi się w różnych lokalizacjach.
W kolejnych latach rozwijano protokoły pozwalające łączyć niezależne sieci w większy system. W 1983 roku ARPANET przeszedł na TCP/IP, co uznaje się za jeden z kluczowych momentów rozwoju współczesnego internetu.
Kolejnym przełomem było powstanie World Wide Web, czyli systemu stron internetowych, który zaproponował Tim Berners-Lee pod koniec lat 80. XX wieku. WWW upowszechniło się na początku lat 90.
Należy przy tym rozróżnić dwa pojęcia:
— Internet to infrastruktura i system komunikacji między sieciami.
— World Wide Web (WWW) to jedna z usług działających w internecie, umożliwiająca korzystanie ze stron i aplikacji internetowych.
Internet obejmuje również pocztę elektroniczną, komunikację głosową, przesyłanie plików, gry sieciowe, usługi chmurowe i wiele innych rozwiązań.
Internet jako sieć sieci
Wyobraźmy sobie niewielką sieć domową. Komputer, telewizor i smartfon łączą się z routerem. Router zapewnia dostęp do sieci operatora internetowego. Operator łączy swoją infrastrukturę z innymi sieciami, a te mogą prowadzić do kolejnych operatorów i centrów danych.
W ten sposób powstaje rozległy system połączeń.
Dane nie muszą zawsze podróżować tą samą drogą. W zależności od dostępnych tras, konfiguracji sieci i warunków technicznych mogą być przesyłane różnymi ścieżkami.
Ta elastyczność jest jedną z ważnych cech internetu.
6.2. Jak działa sieć komputerowa?
Sieć komputerowa to zbiór urządzeń połączonych w celu wymiany danych i współdzielenia zasobów.
Urządzenia te mogą obejmować:
— komputery stacjonarne i laptopy,
— smartfony i tablety,
— serwery,
— drukarki sieciowe,
— routery i przełączniki,
— kamery internetowe,
— telewizory i urządzenia inteligentnego domu,
— gogle rzeczywistości wirtualnej.
Sieć umożliwia między innymi przesyłanie dokumentów, udostępnianie drukarek, korzystanie z baz danych i łączenie się z usługami działającymi na innych komputerach.
Sieci lokalne i rozległe
Jednym z podstawowych podziałów jest rozróżnienie sieci lokalnych i rozległych.
LAN (Local Area Network) to sieć lokalna. Może obejmować mieszkanie, biuro, szkołę lub budynek przedsiębiorstwa. Urządzenia są zazwyczaj połączone przez Ethernet lub Wi-Fi.
WAN (Wide Area Network) to sieć rozległa, która łączy urządzenia lub sieci znajdujące się na większym obszarze geograficznym.
Internet można rozumieć jako globalny system współpracujących sieci, wykorzystujący wiele technologii komunikacyjnych.
W praktyce granice między kategoriami sieci mogą zależeć od sposobu ich organizacji i przyjętej terminologii.
Klient i serwer
W wielu systemach informatycznych urządzenia pełnią role klienta lub serwera.
Klient to program albo urządzenie, które korzysta z usługi. Przykładem jest przeglądarka internetowa wysyłająca żądanie pobrania strony.
Serwer to komputer lub oprogramowanie udostępniające usługę innym urządzeniom.
Przykładowy proces wygląda następująco:
— Użytkownik otwiera przeglądarkę.
— Przeglądarka wysyła żądanie do serwera.
— Serwer analizuje żądanie.
— Serwer przygotowuje odpowiedź.
— Odpowiedź trafia do przeglądarki.
— Przeglądarka wyświetla otrzymaną treść.
Serwer nie musi być pojedynczym fizycznym komputerem. Usługa może działać na wielu maszynach, a użytkownik może nawet nie wiedzieć, gdzie dokładnie są przetwarzane jego dane.
Topologie sieci
Topologia opisuje sposób połączenia urządzeń w sieci.
W topologii gwiazdy urządzenia są połączone z centralnym punktem, na przykład przełącznikiem. Jest to popularne rozwiązanie w sieciach Ethernet.
W topologii magistrali urządzenia współdzielą wspólne medium komunikacyjne. Rozwiązanie to miało znaczenie w starszych sieciach lokalnych.
W topologii pierścienia urządzenia są połączone w układ przypominający zamknięty pierścień.
W rozległych sieciach spotyka się także układy częściowo lub silnie redundantne, w których istnieje więcej niż jedna możliwa droga komunikacji.
Współczesne sieci mogą łączyć elementy różnych topologii. Najważniejsze jest zapewnienie odpowiedniej przepustowości, niezawodności, bezpieczeństwa i możliwości rozbudowy.
6.3. Adresy IP — identyfikacja urządzeń w sieci
Aby urządzenia mogły wymieniać dane, muszą korzystać z adresowania sieciowego.
Podstawową rolę odgrywa tutaj adres IP, czyli adres używany w protokole Internet Protocol.
Adres IP umożliwia identyfikację interfejsu sieciowego w określonym kontekście komunikacji. Nie zawsze oznacza to trwałe lub jednoznaczne przypisanie adresu do konkretnego fizycznego urządzenia.
Istnieją dwie główne wersje protokołu IP: IPv4 i IPv6.
IPv4
Adres IPv4 ma długość 32 bitów. Zazwyczaj zapisuje się go jako cztery liczby dziesiętne oddzielone kropkami.
Przykład:
192.168.1.25
Każda z czterech części może przyjmować wartość od 0 do 255.
IPv4 oferuje około 4,3 miliarda możliwych adresów. W praktyce część z nich jest zarezerwowana do specjalnych zastosowań, a ogromna liczba urządzeń podłączonych do internetu sprawiła, że pula dostępnych publicznych adresów IPv4 stała się niewystarczająca.
Adresy prywatne i publiczne
W sieciach lokalnych często używa się prywatnych adresów IPv4.
Do najważniejszych zakresów należą:
— 10.0.0.0/8
— 172.16.0.0/12
— 192.168.0.0/16
Adres 192.168.1.25 może być przykładem prywatnego adresu komputera w sieci domowej.
Adres publiczny jest wykorzystywany do komunikacji w publicznej infrastrukturze internetowej. Zazwyczaj przy połączeniu domowym router lub urządzenie operatora korzysta z publicznego adresu, podczas gdy komputery w sieci lokalnej mają adresy prywatne.
Często stosuje się mechanizm NAT, czyli translację adresów sieciowych. Pozwala on wielu urządzeniom korzystającym z prywatnych adresów IPv4 współdzielić jeden publiczny adres IPv4.
Nie jest to jednak jedyny możliwy model. W niektórych sieciach operatorzy stosują również CGNAT, czyli translację adresów na poziomie infrastruktury operatora.
IPv6
IPv6 opracowano między innymi po to, aby zapewnić znacznie większą przestrzeń adresową.
Adres IPv6 ma 128 bitów i zapisuje się go szesnastkowo, oddzielając grupy dwukropkami.
Przykład:
2001:db8::1
Zakres 2001:db8::/32 jest przeznaczony do dokumentacji i przykładów, dlatego nie należy traktować tego adresu jako typowego adresu działającego serwera publicznego.
IPv6 umożliwia utworzenie ogromnej liczby adresów i wprowadza rozwiązania ułatwiające rozwój współczesnych sieci. W praktyce IPv4 i IPv6 nadal współistnieją.
Maska sieci i brama domyślna
Sam adres IP to nie wszystko.
Maska podsieci lub zapis prefiksu określa, jaka część adresu jest związana z siecią, a jaka z adresem interfejsu w danej podsieci.
Na przykład zapis 192.168.1.25/24 wskazuje, że pierwsze 24 bity stanowią prefiks sieci. W typowej sieci IPv4 odpowiada to masce 255.255.255.0.
Brama domyślna to urządzenie, do którego komputer przekazuje pakiety przeznaczone do sieci, z którymi nie może komunikować się bezpośrednio. W domu funkcję tę zazwyczaj pełni router.
Warto pamiętać, że adres IP nie jest tym samym co adres MAC. Adres MAC jest używany w komunikacji warstwy łącza danych, na przykład w sieci Ethernet, podczas gdy adres IP służy do komunikacji na poziomie protokołu IP.
6.4. DNS — jak nazwy domen zamieniają się w adresy IP
Użytkownicy wolą zapamiętywać nazwy takie jak example.com niż ciągi liczb.
Dlatego w internecie wykorzystuje się DNS, czyli Domain Name System.
DNS to rozproszony system nazw, który pozwala między innymi odnajdywać adresy IP przypisane do nazw domenowych.
Gdy wpisujemy nazwę strony w przeglądarce, komputer może potrzebować wykonać zapytanie DNS, aby ustalić, z jakim adresem IP powinien nawiązać połączenie.
Jak przebiega rozwiązywanie nazwy?
W uproszczeniu proces wygląda następująco:
— Użytkownik wpisuje nazwę domeny.
— System sprawdza, czy potrzebna informacja znajduje się już w pamięci podręcznej.
— Jeśli odpowiedzi nie ma, klient korzysta z skonfigurowanego resolvera DNS.
— Resolver może wykorzystać własną pamięć podręczną albo przeprowadzić dalsze zapytania.
— W razie potrzeby odpytywane są serwery DNS odpowiedzialne za kolejne poziomy hierarchii nazw.
— Ostatecznie resolver otrzymuje odpowiedź i przekazuje ją klientowi.
Warto podkreślić, że nie każde zapytanie wymaga przejścia przez wszystkie etapy. Dzięki pamięci podręcznej odpowiedź może być dostępna bardzo szybko.
Hierarchia DNS
System DNS jest zorganizowany hierarchicznie.
Na szczycie znajdują się serwery główne, czyli root servers. Pomagają one odnaleźć serwery odpowiedzialne za domeny najwyższego poziomu.
Do domen najwyższego poziomu należą między innymi:
— .pl
— .com
— .org
— .net
Dalej znajdują się serwery odpowiedzialne za konkretne domeny.
Właściciel domeny może skonfigurować różne rekordy DNS, zależnie od potrzeb swojej infrastruktury.
Najważniejsze rodzaje rekordów DNS
A — wskazuje adres IPv4.
AAAA — wskazuje adres IPv6.
CNAME — tworzy alias wskazujący na inną nazwę domenową.
MX — określa serwery obsługujące pocztę elektroniczną dla domeny.
TXT — przechowuje tekstowe informacje wykorzystywane między innymi do weryfikacji domen oraz konfiguracji zabezpieczeń poczty.
NS — wskazuje serwery nazw odpowiedzialne za daną strefę DNS.
DNS nie służy wyłącznie do wyszukiwania stron internetowych. Jest ważnym elementem działania poczty, usług chmurowych, systemów uwierzytelniania i wielu innych rozwiązań.
Czy DNS gwarantuje bezpieczeństwo?
Nie. DNS pomaga odnaleźć właściwy adres, ale samo rozwiązanie nazwy nie gwarantuje, że strona jest bezpieczna.
Przestępca może zarejestrować domenę przypominającą nazwę popularnego serwisu i wykorzystać ją do phishingu. Dlatego przed podaniem hasła lub danych płatniczych należy sprawdzać domenę, a także korzystać z uwierzytelniania wieloskładnikowego i innych zabezpieczeń.
Istnieją również mechanizmy zwiększające bezpieczeństwo DNS, takie jak DNSSEC, które pomagają weryfikować autentyczność danych DNS. DNSSEC nie szyfruje jednak całej komunikacji i nie zastępuje HTTPS.
6.5. Routery, przełączniki i modemy
Urządzenia sieciowe odpowiadają za przekazywanie danych, łączenie segmentów sieci i zapewnianie dostępu do internetu.
Na pierwszy rzut oka router, przełącznik i modem mogą wyglądać podobnie. Pełnią jednak różne funkcje.
Przełącznik sieciowy
Przełącznik, czyli switch, łączy urządzenia w sieci lokalnej.
W typowej sieci Ethernet przełącznik wykorzystuje adresy MAC do przekazywania ramek do odpowiednich portów. Dzięki temu dane nie muszą być wysyłane do wszystkich urządzeń w sieci przy każdej transmisji.
Przełączniki są wykorzystywane w domach, biurach, szkołach i centrach danych.
Niektóre modele oferują dodatkowe funkcje, takie jak obsługa sieci VLAN, zasilanie PoE czy zarządzanie ruchem.
Router
Router łączy różne sieci i przekazuje między nimi pakiety IP.
W domu router najczęściej umożliwia komunikację między siecią lokalną a siecią operatora internetowego. Może również realizować funkcje zapory sieciowej, NAT, serwera DHCP i punktu dostępowego Wi-Fi.
Wiele urządzeń sprzedawanych jako routery domowe łączy w jednej obudowie kilka funkcji: routera, przełącznika Ethernet, punktu dostępowego i czasem modemu.
Modem i urządzenie dostępu do internetu
Modem lub inne urządzenie dostępowe zapewnia połączenie z infrastrukturą operatora. Konkretne rozwiązanie zależy od technologii.
W przypadku światłowodu często stosuje się urządzenie ONT, które kończy połączenie optyczne i przekazuje dane dalej do routera.
W sieciach kablowych może być wykorzystywany modem kablowy, a w internecie mobilnym — modem LTE lub 5G.
Nie każdy dostęp do internetu wymaga osobnego urządzenia nazywanego modemem. W niektórych instalacjach funkcje te są zintegrowane z innymi urządzeniami.
Punkt dostępowy Wi-Fi
Punkt dostępowy umożliwia urządzeniom bezprzewodowym dołączanie do sieci lokalnej.
W typowym domu funkcję tę pełni router Wi-Fi. W większych budynkach można stosować wiele punktów dostępowych, aby zwiększyć zasięg i pojemność sieci.
Sama liczba kresek zasięgu nie mówi wszystkiego o jakości połączenia. Znaczenie mają również zakłócenia, przeciążenie kanału, możliwości urządzenia, odległość od punktu dostępowego i przepustowość łącza internetowego.
Jak te urządzenia współpracują?
Przykładowy układ domowy może wyglądać tak:
Laptop → Wi-Fi → router → urządzenie operatora → sieć operatora → internet → serwer docelowy
W zależności od instalacji router i urządzenie operatora mogą być osobnymi urządzeniami albo jednym zintegrowanym sprzętem.
Każdy element musi prawidłowo realizować swoją funkcję, aby komunikacja przebiegała bez zakłóceń.
6.6. Protokoły sieciowe: TCP/IP, HTTP i HTTPS
Protokół to zestaw zasad określających, w jaki sposób urządzenia wymieniają informacje.
Bez wspólnych protokołów komputer jednego producenta mógłby nie rozumieć danych wysyłanych przez urządzenie innej firmy.
Internet wykorzystuje wiele protokołów, które współpracują na różnych poziomach komunikacji.
Model warstwowy
Komunikację sieciową można opisywać za pomocą modelu warstwowego.
W praktyce często wykorzystuje się model TCP/IP, który grupuje funkcje komunikacji w kilka warstw.
W uproszczeniu obejmuje on:
— Warstwę dostępu do sieci — odpowiada za komunikację w danym medium, na przykład Ethernet lub Wi-Fi.
— Warstwę internetową — obejmuje protokół IP, który odpowiada za adresowanie i przekazywanie pakietów między sieciami.
— Warstwę transportową — obejmuje między innymi TCP i UDP.
— Warstwę aplikacji — obejmuje protokoły i usługi, z których korzystają aplikacje, na przykład HTTP, DNS czy SMTP.
Modele warstwowe pomagają zrozumieć, dlaczego aplikacja nie musi samodzielnie sterować sygnałem radiowym albo określać fizycznego sposobu przesyłania bitów.
TCP — kontrolowana transmisja danych
TCP, czyli Transmission Control Protocol, zapewnia strumień danych pomiędzy aplikacjami.
W typowych zastosowaniach TCP dba o uporządkowanie danych, wykrywanie utraty segmentów i ponowne przesyłanie brakujących informacji.
Jeżeli część danych nie dotrze do odbiorcy, protokół może uruchomić mechanizmy retransmisji. Dzięki temu aplikacja otrzymuje uporządkowany strumień bajtów.
TCP nie gwarantuje jednak, że każda aplikacja zadziała poprawnie. Odpowiada za określone aspekty transportu danych, a nie za całą logikę systemu.
UDP — prostszy transport
UDP, czyli User Datagram Protocol, przesyła datagramy bez zapewnienia wszystkich mechanizmów kontroli charakterystycznych dla TCP.
Nie gwarantuje dostarczenia wszystkich datagramów ani ich kolejności. Dzięki temu może być przydatny w zastosowaniach, w których ważne są niskie opóźnienia lub samodzielne zarządzanie transmisją przez aplikację.
UDP jest wykorzystywany między innymi w niektórych zastosowaniach multimedialnych, grach sieciowych oraz w komunikacji DNS.
Nie oznacza to, że UDP zawsze jest szybszy od TCP. Rzeczywista wydajność zależy od charakteru aplikacji, warunków sieciowych i użytych mechanizmów.
IP — przekazywanie pakietów
IP odpowiada za adresowanie i przekazywanie pakietów między sieciami.
Nie zapewnia samo w sobie niezawodnego dostarczenia wszystkich danych. Zajmuje się przede wszystkim przenoszeniem pakietów przez sieć, pozostawiając inne zadania protokołom wyższych warstw.
HTTP — komunikacja z usługami internetowymi
HTTP, czyli Hypertext Transfer Protocol, jest jednym z podstawowych protokołów wykorzystywanych do komunikacji między klientami a serwerami internetowymi.
Przeglądarka może wysłać żądanie pobrania strony, a serwer odpowiada odpowiednimi danymi.
HTTP jest używany nie tylko do przesyłania dokumentów HTML. Wykorzystuje się go również w interfejsach API, aplikacjach internetowych i usługach sieciowych.
HTTPS — szyfrowana komunikacja
HTTPS to HTTP działający z wykorzystaniem zabezpieczeń TLS.
TLS pomaga zapewnić poufność i integralność przesyłanych danych, a także umożliwia uwierzytelnienie serwera na podstawie certyfikatu.
Dzięki temu osoba przechwytująca ruch sieciowy nie powinna móc po prostu odczytać treści prawidłowo zabezpieczonej sesji HTTPS.
Należy jednak pamiętać, że HTTPS nie gwarantuje uczciwości właściciela strony. Fałszywa witryna również może posiadać prawidłowy certyfikat TLS. Szyfrowanie chroni połączenie, ale nie zastępuje oceny wiarygodności serwisu.
Porty sieciowe
Adres IP identyfikuje interfejs w sieci, natomiast numer portu pomaga wskazać odpowiednią usługę lub punkt końcowy komunikacji transportowej.
Przykładowe porty to:
— TCP 80 — często wykorzystywany przez HTTP,
— TCP 443 — często wykorzystywany przez HTTPS,
— TCP 22 — często wykorzystywany przez SSH,
— UDP 53 i TCP 53 — wykorzystywane przez DNS, zależnie od rodzaju zapytania i sytuacji.
Port nie jest fizycznym gniazdem w komputerze. To logiczny numer używany przez stos sieciowy do kierowania komunikacji do odpowiedniego procesu lub usługi.
6.7. Serwery i usługi internetowe
Serwery stanowią jeden z filarów współczesnego internetu.
Są to systemy udostępniające usługi innym urządzeniom. Mogą obsługiwać strony internetowe, pocztę elektroniczną, gry, bazy danych, pliki, aplikacje biznesowe lub modele sztucznej inteligencji.
Serwer fizyczny i serwer wirtualny
Serwer fizyczny to rzeczywista maszyna komputerowa wyposażona w procesor, pamięć RAM, dyski i interfejsy sieciowe.
Może działać przez wiele lat, obsługując usługi dla użytkowników z całego świata.
Serwer wirtualny jest natomiast środowiskiem programowym działającym na współdzielonym sprzęcie. Wirtualizacja pozwala uruchomić wiele niezależnych maszyn wirtualnych na jednym serwerze fizycznym.
W nowoczesnych infrastrukturach wykorzystuje się również kontenery i platformy orkiestracji, które ułatwiają uruchamianie oraz skalowanie aplikacji.
Serwery WWW
Serwer WWW udostępnia zasoby przez protokół HTTP lub HTTPS.
Może zwracać gotowe pliki, takie jak obrazy, arkusze stylów i dokumenty HTML, albo przekazywać żądania do aplikacji generującej odpowiedź na bieżąco.
Przykładowo strona sklepu internetowego może być zbudowana z wielu elementów:
— serwera WWW,
— aplikacji obsługującej logikę sklepu,
— bazy danych produktów,
— systemu zarządzania płatnościami,
— usługi wysyłania wiadomości,
— systemu monitorowania i zabezpieczeń.
Użytkownik widzi jeden sklep, ale w tle może działać wiele niezależnych komponentów.
Bazy danych
Baza danych służy do przechowywania i organizowania informacji.
Serwisy internetowe mogą przechowywać w bazach danych profile użytkowników, zamówienia, produkty, wpisy, konfiguracje i inne informacje.
W zależności od zastosowania wykorzystuje się relacyjne bazy danych, bazy dokumentowe, magazyny klucz–wartość oraz inne systemy.
Dobra organizacja danych jest ważna dla wydajności, niezawodności i bezpieczeństwa aplikacji.
Skalowanie usług
Jeżeli z aplikacji korzysta coraz więcej użytkowników, pojedynczy serwer może przestać wystarczać.
Jednym z rozwiązań jest skalowanie pionowe, czyli zwiększenie zasobów pojedynczej maszyny. Można na przykład dodać pamięć RAM lub wykorzystać mocniejszy procesor.
Inną metodą jest skalowanie poziome, czyli uruchomienie dodatkowych instancji aplikacji.
W takim układzie ruch może być rozdzielany przez mechanizm równoważenia obciążenia, nazywany load balancerem.
Skalowanie poziome jest często wykorzystywane w usługach internetowych o dużej liczbie użytkowników. Wymaga jednak odpowiedniego zaprojektowania aplikacji i sposobu przechowywania stanu.
6.8. Jak działa przeglądarka internetowa?
Przeglądarka internetowa jest aplikacją umożliwiającą korzystanie ze stron i aplikacji WWW.
Do popularnych przeglądarek należą Chrome, Firefox, Edge i Safari.
Przeglądarka nie jest jedynie programem wyświetlającym tekst. To złożone środowisko, które pobiera zasoby, interpretuje kod, wykonuje skrypty i renderuje interfejs.
HTML, CSS i JavaScript
Trzy ważne technologie tworzenia stron internetowych to HTML, CSS i JavaScript.
HTML określa strukturę dokumentu. Może opisywać nagłówki, akapity, obrazy, formularze i odnośniki.
CSS odpowiada za prezentację, czyli między innymi kolory, rozmieszczenie elementów, typografię i dostosowanie wyglądu do różnych ekranów.
JavaScript pozwala tworzyć interaktywne funkcje. Może reagować na kliknięcia, aktualizować treść strony i komunikować się z serwerem.
Nowoczesne aplikacje internetowe mogą wykorzystywać również wiele bibliotek, frameworków i narzędzi budowania.
Renderowanie strony
Po otrzymaniu zasobów przeglądarka analizuje dokument HTML, pobiera powiązane pliki i przygotowuje strukturę strony.
Na podstawie HTML i CSS oblicza sposób rozmieszczenia elementów. Następnie renderuje treść na ekranie.
W międzyczasie JavaScript może wykonywać dodatkowe operacje, na przykład pobierać dane z serwera i aktualizować widok.
Dlatego dwie strony internetowe mogą różnić się pod względem szybkości działania, nawet jeśli użytkownik otwiera je na tym samym komputerze.
Na wydajność wpływają między innymi wielkość pobieranych plików, liczba żądań sieciowych, złożoność kodu, wydajność serwera oraz możliwości urządzenia użytkownika.
Pamięć podręczna
Przeglądarki mogą przechowywać kopie niektórych zasobów, aby nie pobierać ich ponownie przy każdym otwarciu strony.
Mechanizm ten nazywa się cache, czyli pamięcią podręczną.
Jeżeli obraz lub arkusz stylów nie uległ zmianie i odpowiednie nagłówki HTTP pozwalają wykorzystać zapisaną kopię, przeglądarka może wczytać stronę szybciej.
Podobne mechanizmy stosują serwery, systemy DNS i sieci dostarczania treści.
6.9. Wi-Fi, sieci przewodowe i internet mobilny
Urządzenia mogą łączyć się z siecią na różne sposoby. Wybór technologii wpływa na szybkość, opóźnienia, stabilność, zasięg i bezpieczeństwo połączenia.
Ethernet
Ethernet jest powszechną technologią sieci przewodowych.
Połączenia Ethernet wykorzystują najczęściej przewody miedziane ze złączami RJ-45, choć w infrastrukturze sieciowej używa się również światłowodów i innych rozwiązań.
Połączenie przewodowe często zapewnia stabilne parametry, niskie opóźnienia i mniejszą podatność na zakłócenia radiowe.
Dlatego Ethernet jest popularny w komputerach stacjonarnych, serwerach, konsolach i stanowiskach pracy wymagających stabilnej komunikacji.
Wi-Fi
Wi-Fi umożliwia bezprzewodowe łączenie urządzeń z siecią lokalną.
Technologia ta jest wygodna, ponieważ pozwala korzystać z internetu bez prowadzenia przewodu do każdego urządzenia.
Jakość połączenia zależy jednak od wielu czynników, takich jak odległość od punktu dostępowego, przeszkody budowlane, zakłócenia, liczba użytkowników i możliwości sprzętu.
Nowsze generacje Wi-Fi wprowadzają rozwiązania poprawiające przepustowość i efektywność komunikacji. Osiągana prędkość zależy jednak od całej konfiguracji sieci, a nie tylko od nazwy standardu.
Internet mobilny
Sieci komórkowe, takie jak LTE i 5G, umożliwiają transmisję danych bez potrzeby korzystania z lokalnego łącza przewodowego.
Smartfon łączy się ze stacją bazową operatora, a następnie dane są przekazywane przez infrastrukturę sieci komórkowej.
Internet mobilny pozwala korzystać z usług online w podróży i w miejscach, w których nie ma tradycyjnego łącza.
Rzeczywista szybkość zależy między innymi od zasięgu, obciążenia stacji bazowej, pasma częstotliwości, urządzenia oraz infrastruktury operatora.
Przepustowość a opóźnienie
Warto rozróżnić dwa pojęcia.
Przepustowość określa ilość danych, jaką można przesłać w określonym czasie. Często podaje się ją w megabitach na sekundę lub gigabitach na sekundę.
Opóźnienie opisuje czas potrzebny na przekazanie danych między punktami. Często mierzy się je w milisekundach.
Wysoka przepustowość jest ważna przy pobieraniu dużych plików i przesyłaniu obrazu w wysokiej rozdzielczości.
Niskie opóźnienie ma szczególne znaczenie w grach online, wideokonferencjach, zdalnym sterowaniu oraz aplikacjach VR korzystających ze zdalnego przetwarzania.
Nie należy utożsamiać szybkości łącza z jego opóźnieniem. Połączenie może oferować dużą przepustowość, a jednocześnie mieć zbyt wysokie opóźnienie dla konkretnego zastosowania interaktywnego.
6.10. Chmura obliczeniowa — przechowywanie danych i moc obliczeniowa
Chmura obliczeniowa, czyli cloud computing, polega na udostępnianiu zasobów informatycznych przez sieć.
Zamiast kupować i utrzymywać wszystkie serwery samodzielnie, organizacja może wynajmować zasoby od dostawcy usług chmurowych.
Zależnie od potrzeb mogą to być maszyny wirtualne, bazy danych, przestrzeń dyskowa, środowiska programistyczne, narzędzia analityczne lub usługi sztucznej inteligencji.
Jak działa chmura?
Wyobraźmy sobie osobę, która chce przechowywać zdjęcia i dokumenty.
Może zapisać je wyłącznie na lokalnym dysku komputera. W takim przypadku dostęp do danych zależy między innymi od sprawności tego urządzenia.
Może też korzystać z usługi chmurowej, która zapisuje pliki na zdalnej infrastrukturze. Użytkownik może wówczas uzyskiwać do nich dostęp z różnych urządzeń, o ile ma odpowiednie uprawnienia i połączenie z usługą.
W tle mogą działać serwery, systemy przechowywania danych, mechanizmy replikacji i oprogramowanie zarządzające dostępem.
Chmura nie oznacza więc, że dane znajdują się w niematerialnej przestrzeni. Są przechowywane i przetwarzane na fizycznych urządzeniach umieszczonych w centrach danych.
Najważniejsze cechy chmury
Jedną z istotnych cech jest samoobsługowy dostęp do zasobów. Użytkownik może często uruchamiać nowe maszyny lub zwiększać przestrzeń dyskową bez konieczności fizycznej instalacji sprzętu.
Kolejną cechą jest elastyczność. Zasoby można zwiększać lub zmniejszać zależnie od zapotrzebowania, w granicach możliwości danej usługi.
Wiele usług chmurowych rozlicza się na podstawie wykorzystania zasobów lub wybranego planu. Pozwala to ograniczyć początkowe wydatki, ale nie oznacza automatycznie niższych kosztów w każdej sytuacji.
Dostawcy chmury oferują również narzędzia monitorowania, kopie zapasowe, mechanizmy bezpieczeństwa i usługi automatyzujące zarządzanie infrastrukturą.
Chmura publiczna, prywatna i hybrydowa
Chmura publiczna to zasoby udostępniane przez dostawcę wielu klientom. Każdy klient korzysta z przydzielonych mu zasobów i odpowiednich mechanizmów izolacji.
Chmura prywatna to środowisko przeznaczone dla jednej organizacji. Może działać we własnym centrum danych albo korzystać z infrastruktury zewnętrznej.
Chmura hybrydowa łączy środowiska o różnym charakterze, na przykład własną infrastrukturę przedsiębiorstwa z usługami chmury publicznej.
Wybór modelu zależy od wymagań dotyczących bezpieczeństwa, kosztów, zgodności z przepisami, kontroli nad danymi i dostępności specjalistycznych usług.
Chmura a lokalny komputer
Chmura nie musi zastępować komputera użytkownika.
W wielu zastosowaniach najlepszym rozwiązaniem jest połączenie lokalnego urządzenia i zdalnych usług.
Komputer może wykonywać część obliczeń lokalnie, a trudniejsze zadania przekazywać do chmury. Takie podejście jest wykorzystywane między innymi w analizie danych, tworzeniu oprogramowania i sztucznej inteligencji.
Trzeba jednak pamiętać, że dostęp do zasobów chmurowych zależy od jakości połączenia, dostępności usługi, konfiguracji oraz warunków umowy z dostawcą.
6.11. IaaS, PaaS i SaaS — trzy modele usług chmurowych
Usługi chmurowe można podzielić na kilka kategorii. Do najważniejszych należą IaaS, PaaS i SaaS.
Różnią się one zakresem odpowiedzialności użytkownika oraz poziomem abstrakcji, na jakim udostępniane są zasoby.
IaaS — Infrastructure as a Service
IaaS oznacza infrastrukturę jako usługę.
Klient otrzymuje dostęp do zasobów takich jak maszyny wirtualne, sieci wirtualne i dyski.
Dostawca odpowiada za fizyczną infrastrukturę oraz warstwę jej udostępniania. Klient zarządza natomiast znaczną częścią konfiguracji systemu operacyjnego, oprogramowania i aplikacji.
Przykładowe zastosowania IaaS:
— uruchamianie serwerów WWW,
— tworzenie środowisk testowych,
— przechowywanie danych,
— wdrażanie aplikacji biznesowych,
— uruchamianie własnych usług wymagających specjalnej konfiguracji.
IaaS daje dużą elastyczność, ale wymaga również wiedzy technicznej i odpowiedzialności za prawidłowe zabezpieczenie środowiska.
PaaS — Platform as a Service
PaaS oznacza platformę jako usługę.
Dostawca udostępnia środowisko ułatwiające tworzenie, wdrażanie i uruchamianie aplikacji. Użytkownik może skupić się na kodzie i logice biznesowej, zamiast samodzielnie zarządzać każdym elementem infrastruktury.
W zależności od platformy usługa może obejmować środowisko uruchomieniowe, integrację z bazami danych, mechanizmy wdrażania i narzędzia monitorowania.
PaaS jest szczególnie przydatny dla programistów, którzy chcą szybko udostępnić aplikację użytkownikom.
SaaS — Software as a Service
SaaS oznacza oprogramowanie jako usługę.
Użytkownik korzysta z gotowej aplikacji udostępnianej przez internet. Nie musi samodzielnie instalować i utrzymywać całej infrastruktury serwerowej.
Przykładami takich rozwiązań są internetowe systemy poczty, aplikacje biurowe, narzędzia do zarządzania projektami oraz wiele platform współpracy.
W modelu SaaS dostawca zarządza dużą częścią technicznego zaplecza. Użytkownik nadal odpowiada jednak za właściwe korzystanie z usługi, ochronę swoich danych dostępowych i konfigurację dostępnych zabezpieczeń.
Porównanie modeli
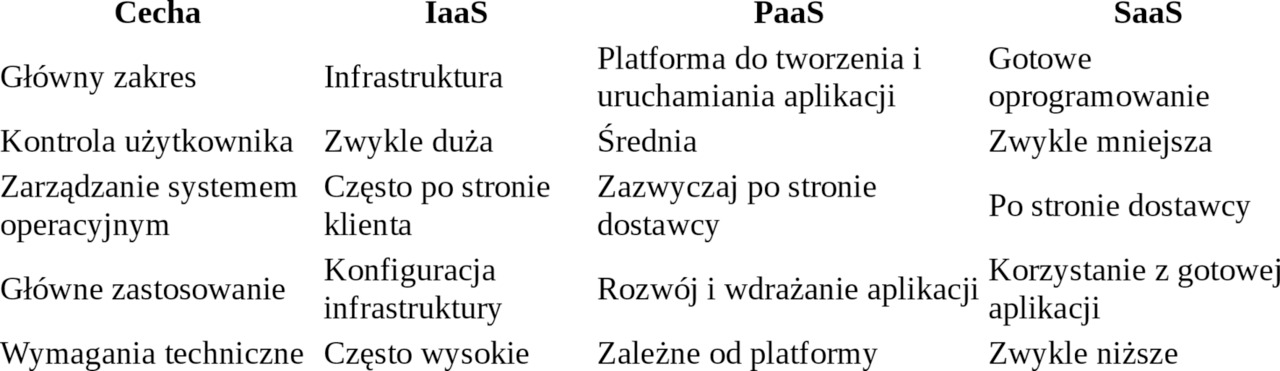
Warto pamiętać, że rzeczywisty podział odpowiedzialności zależy od konkretnej usługi. Nazwa modelu nie zwalnia użytkownika z obowiązku sprawdzenia zasad bezpieczeństwa i zakresu odpowiedzialności.
6.12. Centra danych i infrastruktura internetu
Kiedy wysyłamy wiadomość, zapisujemy plik w chmurze lub uruchamiamy aplikację AI, nasze żądanie może trafić do infrastruktury oddalonej o setki lub tysiące kilometrów.
Takie usługi są często obsługiwane przez centra danych.
Czym jest centrum danych?
Centrum danych to obiekt przeznaczony do utrzymywania infrastruktury informatycznej.
Znajdują się w nim serwery, systemy przechowywania danych, urządzenia sieciowe oraz instalacje wspierające ich nieprzerwaną pracę.
Centra danych wymagają między innymi:
— stabilnego zasilania,
— odpowiedniego chłodzenia,
— ochrony fizycznej,
— kontroli dostępu,
— monitorowania środowiska,
— łączności sieciowej,
— procedur reagowania na awarie.
W przypadku dużych obiektów stosuje się rozwiązania pozwalające utrzymać usługi mimo awarii pojedynczych komponentów.
Nie oznacza to jednak, że każde centrum danych ma identyczny poziom redundancji. Architektura zależy od przeznaczenia obiektu, kosztów i wymagań dostępności.
Chłodzenie i zużycie energii
Serwery zużywają energię elektryczną, a znaczna jej część zamienia się w ciepło.
Dlatego centra danych potrzebują systemów chłodzenia, które utrzymują urządzenia w odpowiednich warunkach pracy.
W zależności od infrastruktury wykorzystuje się różne rozwiązania, takie jak chłodzenie powietrzem, systemy cieczy chłodzącej czy specjalistyczne układy dla serwerów o wysokiej gęstości mocy.
Rosnące zapotrzebowanie na obliczenia AI sprawia, że efektywność energetyczna staje się coraz ważniejszym zagadnieniem technicznym i ekonomicznym.
Światłowody i podmorskie kable
Znaczna część globalnej komunikacji internetowej między kontynentami odbywa się za pośrednictwem podmorskich kabli światłowodowych.
Światłowody przesyłają dane za pomocą sygnałów świetlnych. Pozwalają osiągać wysokie przepustowości i przesyłać informacje na duże odległości.
Internet nie opiera się wyłącznie na komunikacji satelitarnej. Choć satelity odgrywają ważną rolę, szczególnie w dostępie do sieci w odległych miejscach, międzynarodowy ruch danych w dużej mierze korzysta z infrastruktury kablowej.
CDN — sieci dostarczania treści
CDN, czyli Content Delivery Network, to sieć serwerów rozmieszczonych w różnych lokalizacjach, która pomaga dostarczać treści użytkownikom.
Zamiast pobierać każdy obraz, plik lub materiał wideo z jednego odległego serwera, użytkownik może otrzymać kopię zasobu z bliższego punktu infrastruktury.
CDN może skrócić czas ładowania strony, ograniczyć obciążenie serwera źródłowego i poprawić odporność usługi na duży ruch.
Nie wszystkie dane mogą być jednak buforowane. Treści spersonalizowane lub poufne często wymagają odrębnego podejścia.
6.13. Cyberbezpieczeństwo w sieci
Internet daje ogromne możliwości, ale wiąże się również z zagrożeniami.
Cyberbezpieczeństwo obejmuje techniki, procedury i rozwiązania służące ochronie systemów, sieci, aplikacji oraz danych przed nieuprawnionym dostępem, uszkodzeniem lub zakłóceniem działania.
Nie istnieje jedno narzędzie, które zapewnia pełne bezpieczeństwo. Skuteczna ochrona wymaga połączenia technologii, prawidłowej konfiguracji i odpowiednich zachowań użytkowników.
Najczęstsze zagrożenia
Phishing polega na nakłanianiu użytkownika do ujawnienia informacji, takich jak hasła, dane płatnicze lub kody uwierzytelniające.
Przestępcy mogą podszywać się pod bank, firmę kurierską, pracodawcę albo popularny serwis internetowy.
Złośliwe oprogramowanie może kraść dane, szpiegować użytkownika, szyfrować pliki lub wykorzystywać komputer do innych niepożądanych działań.
Ataki na hasła obejmują między innymi próby odgadnięcia słabych haseł, wykorzystywanie haseł ujawnionych w wyciekach i automatyczne testowanie wielu kombinacji.
Ataki typu DDoS polegają na przeciążaniu usługi dużą liczbą żądań lub innym ruchem, tak aby utrudnić jej dostępność dla prawidłowych użytkowników.
Luki w oprogramowaniu mogą pozwalać na wykonanie niepożądanych operacji, przejęcie konta albo uzyskanie dostępu do danych.
Silne hasła i uwierzytelnianie wieloskładnikowe
Hasło powinno być trudne do odgadnięcia i nie powinno być ponownie używane w wielu serwisach.
W praktyce pomocne jest korzystanie z menedżera haseł, który pozwala tworzyć i przechowywać unikalne dane logowania.
Dodatkową ochronę zapewnia MFA, czyli uwierzytelnianie wieloskładnikowe.
W takim rozwiązaniu użytkownik musi potwierdzić tożsamość za pomocą więcej niż jednego rodzaju dowodu. Może to być na przykład hasło i potwierdzenie w aplikacji uwierzytelniającej.
Nie wszystkie metody MFA zapewniają taki sam poziom ochrony. Tam, gdzie jest to możliwe, warto rozważyć klucze bezpieczeństwa lub mechanizmy oparte na passkeys.
Aktualizacje oprogramowania
Aktualizacje często zawierają poprawki bezpieczeństwa.
Nieaktualny system operacyjny, przeglądarka, router lub aplikacja może zawierać znane luki, które zostały już naprawione przez producenta.
Warto więc:
— instalować aktualizacje z zaufanych źródeł;
— aktualizować system operacyjny i aplikacje;
— zmieniać domyślne hasła urządzeń sieciowych;
— wyłączać niepotrzebne usługi;
— regularnie wykonywać kopie zapasowe;
— sprawdzać ustawienia dostępu do danych.
Samo zainstalowanie aktualizacji nie wystarcza, jeśli urządzenie pozostaje źle skonfigurowane lub dostęp do konta jest chroniony słabym hasłem.
Publiczne sieci Wi-Fi
Publiczne sieci bezprzewodowe mogą być wygodne, ale użytkownik powinien zachować ostrożność.
Należy sprawdzać, czy łączymy się z właściwą siecią, korzystać z HTTPS i unikać ignorowania ostrzeżeń przeglądarki dotyczących certyfikatów.
Nie należy zakładać, że każda sieć o nazwie przypominającej nazwę kawiarni lub hotelu jest rzeczywiście przez tę placówkę udostępniana.
W przypadku dostępu do szczególnie wrażliwych zasobów warto stosować dodatkowe środki ochrony, zgodnie z wymaganiami danej organizacji.
Kopie zapasowe
Kopia zapasowa jest jednym z podstawowych mechanizmów ochrony danych.
Może pomóc odzyskać pliki po awarii dysku, przypadkowym usunięciu danych, ataku ransomware lub innym incydencie.
Ważne jest nie tylko tworzenie kopii, lecz także sprawdzanie, czy można je prawidłowo odtworzyć.
Dane przechowywane w chmurze również mogą wymagać osobnej kopii zapasowej. Synchronizacja plików nie zawsze jest równoważna pełnemu backupowi, ponieważ przypadkowe usunięcie lub zaszyfrowanie danych może zostać zsynchronizowane z innymi urządzeniami.
6.14. Internet i chmura w rozwoju sztucznej inteligencji
Sztuczna inteligencja potrzebuje danych, algorytmów i mocy obliczeniowej.
W wielu zastosowaniach nie da się wygodnie przeprowadzić wszystkich obliczeń na zwykłym komputerze użytkownika. Dlatego infrastruktura internetowa i chmurowa odgrywa ważną rolę w rozwoju AI.
Uczenie modeli AI
Trenowanie dużych modeli może wymagać wielu procesorów graficznych, dużej ilości pamięci, szybkich dysków i wydajnej komunikacji między urządzeniami.
Takie zasoby są często organizowane w klastry obliczeniowe.
Klaster to grupa połączonych komputerów, które współpracują przy wykonywaniu zadań. W systemach AI komunikacja między maszynami może być istotnym czynnikiem wpływającym na czas treningu.
Chmura pozwala organizacjom uzyskiwać dostęp do takich zasobów bez konieczności samodzielnego budowania całej infrastruktury.
Nie oznacza to, że wszystkie modele muszą być trenowane w chmurze. Część zadań można wykonywać na własnym sprzęcie, w laboratorium lub w lokalnym centrum danych.
Korzystanie z modelu AI przez internet
Wyobraźmy sobie aplikację, w której użytkownik wpisuje pytanie i otrzymuje odpowiedź generowaną przez model językowy.
W jednym z możliwych wariantów proces wygląda następująco:
— Użytkownik wpisuje pytanie w aplikacji.
— Aplikacja przygotowuje żądanie.
— Żądanie jest przesyłane do usługi AI przez odpowiednio zabezpieczone połączenie.
— Serwer przetwarza dane przy użyciu modelu.
— Wygenerowana odpowiedź jest zwracana do aplikacji.
— Użytkownik widzi odpowiedź na ekranie.
W tle mogą działać serwery aplikacyjne, systemy uwierzytelniania, mechanizmy limitowania ruchu, systemy monitorowania i infrastruktura obliczeniowa.
W rzeczywistości szczegóły zależą od konkretnej usługi. Model może działać na jednej maszynie, na wielu akceleratorach lub w bardziej złożonym środowisku rozproszonym.
API — interfejs programistyczny
API, czyli Application Programming Interface, to interfejs umożliwiający jednemu programowi korzystanie z funkcji innego systemu.
Dzięki API aplikacja może przekazać tekst do modelu AI, otrzymać wynik, a następnie wykorzystać go we własnym procesie.
Przykładowo przedsiębiorstwo może stworzyć system, który:
— odbiera zapytania klientów,
— pobiera informacje z własnej bazy danych,
— przekazuje odpowiedni kontekst do modelu AI,
— analizuje odpowiedź,
— zapisuje wynik w systemie obsługi klienta.
API pozwala integrować AI z istniejącym oprogramowaniem bez konieczności budowania całego modelu od podstaw.
Korzystanie z API może wiązać się z kosztami zależnymi od liczby żądań, ilości przetwarzanych danych lub innych parametrów określonych przez dostawcę.
AI lokalna i AI w chmurze
Modele AI mogą działać lokalnie na komputerze albo zdalnie na serwerach.
AI lokalna może zapewniać większą kontrolę nad przetwarzanymi danymi i ograniczać zależność od połączenia internetowego. Wymaga jednak odpowiedniego sprzętu, pamięci i konfiguracji.
AI w chmurze umożliwia korzystanie z zasobów, których użytkownik nie musi posiadać lokalnie. Może oferować dostęp do większych modeli i łatwiejszą integrację z aplikacjami internetowymi.
Nie ma jednego rozwiązania najlepszego we wszystkich sytuacjach. Wybór zależy od kosztów, wydajności, prywatności, wymagań prawnych i potrzeb użytkowników.
Prywatność danych w usługach AI
Przesyłanie danych do usługi internetowej może oznaczać, że są one przetwarzane poza urządzeniem użytkownika.
Przed wykorzystaniem poufnych informacji warto sprawdzić warunki usługi, zasady przechowywania danych, opcje ich usuwania i ustawienia prywatności.
W przedsiębiorstwach należy dodatkowo uwzględnić polityki bezpieczeństwa oraz wymagania dotyczące danych osobowych i informacji poufnych.
Sama obecność szyfrowanego połączenia nie rozstrzyga, w jaki sposób dostawca przetwarza i przechowuje przekazane informacje.
6.15. Internet, chmura i rzeczywistość wirtualna
Rzeczywistość wirtualna, czyli VR, tworzy środowisko cyfrowe, z którym użytkownik może wchodzić w interakcję.
Nowoczesne gogle VR wykorzystują ekrany, czujniki ruchu, system śledzenia położenia i oprogramowanie renderujące obraz.
Internet oraz usługi chmurowe mogą rozszerzać możliwości takich systemów.
Gry wieloosobowe
W grze VR wielu użytkowników może przebywać we wspólnym wirtualnym świecie.
Każdy uczestnik korzysta z własnego urządzenia, a aplikacja musi wymieniać informacje o położeniu, ruchach, działaniach i stanie świata.
Serwer może koordynować rozgrywkę i przekazywać aktualizacje do uczestników.
Jeżeli opóźnienia są zbyt duże, ruchy innych graczy mogą być widoczne z opóźnieniem, a interakcje mogą sprawiać wrażenie mniej naturalnych.
W VR szczególnie istotna jest płynność obrazu. Dodatkowe opóźnienie między ruchem użytkownika a wyświetleniem odpowiedniej reakcji może pogarszać komfort korzystania z systemu.
Zdalne renderowanie
Renderowanie to proces generowania obrazu na podstawie sceny, geometrii, materiałów, oświetlenia i innych danych.
W tradycyjnym rozwiązaniu obraz jest obliczany bezpośrednio przez procesor graficzny urządzenia użytkownika.
W niektórych systemach część renderowania może odbywać się na zdalnym serwerze. Gotowy obraz lub skompresowany strumień jest następnie przesyłany do gogli.
Takie rozwiązanie może umożliwić korzystanie z bardziej wymagających scen na urządzeniu o ograniczonej mocy obliczeniowej.
Wymaga jednak odpowiednio szybkiej i stabilnej sieci, a także niskich opóźnień. Trzeba uwzględnić czas renderowania, kodowania obrazu, transmisji, dekodowania i wyświetlenia.
Nie każde doświadczenie VR nadaje się więc do pełnego przeniesienia obliczeń do chmury.
AI w wirtualnym świecie
Sztuczna inteligencja może sterować postaciami niezależnymi, analizować zachowanie użytkownika, generować dialogi lub pomagać w tworzeniu wirtualnych środowisk.
Przykładowo w symulatorze szkoleniowym system AI może prowadzić rozmowę z uczestnikiem i reagować na jego decyzje.
Część logiki może działać bezpośrednio w goglach, a bardziej wymagające zadania mogą być wykonywane na serwerze.
Projektanci muszą przy tym uwzględniać prywatność, opóźnienia i bezpieczeństwo danych, zwłaszcza jeśli system przetwarza głos, ruch lub informacje związane z zachowaniem użytkownika.
6.16. Praktyczny przykład — co dzieje się po wpisaniu adresu strony?
Prześledźmy cały proces na przykładzie użytkownika, który chce otworzyć stronę internetową.
Załóżmy, że komputer jest połączony z domową siecią Wi-Fi, a użytkownik wpisuje w przeglądarce adres domeny.
Krok 1. Użytkownik wpisuje adres
Przeglądarka analizuje wpisany adres i określa, z jakim zasobem chce się połączyć.
Może to być na przykład adres w postaci:
https://example.com
Przeglądarka rozpoznaje schemat HTTPS oraz nazwę domenową.
Krok 2. Komputer sprawdza potrzebne informacje
System i przeglądarka mogą sprawdzić, czy mają już zapisane informacje o domenie, połączeniu lub zasobach strony.
Jeżeli potrzebny adres IP nie znajduje się w pamięci podręcznej, system może rozpocząć rozwiązywanie nazwy przez DNS.
Krok 3. DNS pomaga ustalić adres IP
Komputer wysyła zapytanie do skonfigurowanego resolvera DNS.
Resolver może odszukać odpowiedź w swojej pamięci podręcznej albo wykonać dodatkowe zapytania do infrastruktury DNS.
W rezultacie komputer otrzymuje odpowiedni rekord, na przykład adres IPv4 lub IPv6.
Nie każda domena ma jeden stały adres IP. Duże usługi mogą korzystać z wielu adresów i kierować użytkowników do różnych serwerów.
Krok 4. Komputer ustala drogę komunikacji
Jeśli serwer znajduje się poza lokalną podsiecią, komputer zwykle przekazuje pakiety do bramy domyślnej.
W sieci domowej rolę tę najczęściej pełni router.
Router przekazuje pakiety dalej, korzystając ze swojej tablicy routingu. Kolejne routery w sieci operatorów i innych sieciach pomagają przesłać dane w kierunku serwera docelowego.
Dokładna trasa zależy od konfiguracji i bieżących warunków sieciowych.
Krok 5. Nawiązywane jest połączenie
Przeglądarka nawiązuje komunikację z serwerem.
W klasycznym przypadku HTTPS opartego na TCP najpierw nawiązywane jest połączenie TCP, a następnie negocjowane są parametry zabezpieczeń TLS.
W innych konfiguracjach, na przykład z HTTP/3, wykorzystywany jest protokół QUIC działający na UDP, który integruje mechanizmy transportowe i zabezpieczenia w inny sposób.
W trakcie zestawiania bezpiecznej sesji przeglądarka sprawdza między innymi certyfikat serwera i zgodność jego nazwy z odwiedzaną domeną.
Krok 6. Przeglądarka wysyła żądanie HTTP
Po przygotowaniu komunikacji przeglądarka wysyła żądanie do serwera.
Żądanie może dotyczyć pobrania strony głównej albo innego zasobu.
W zależności od aplikacji może zawierać również nagłówki, informacje o preferencjach klienta i dane związane z sesją użytkownika.
Krok 7. Serwer przygotowuje odpowiedź
Serwer odbiera żądanie i podejmuje odpowiednie działania.
Może zwrócić gotowy dokument HTML, pobrać dane z bazy, wykonać kod aplikacji lub przekazać żądanie do innego komponentu systemu.
W dużych serwisach żądanie może przejść przez kilka warstw infrastruktury, zanim zostanie przygotowana ostateczna odpowiedź.
Krok 8. Dane wracają do przeglądarki
Serwer przesyła odpowiedź przez sieć.
Jeśli komunikacja korzysta z HTTPS, dane są chronione mechanizmami TLS podczas przesyłania przez zabezpieczone połączenie.
Przeglądarka odbiera odpowiedź i analizuje jej zawartość.
Krok 9. Pobierane są dodatkowe zasoby
Dokument HTML może odwoływać się do arkuszy CSS, skryptów JavaScript, obrazów, czcionek i innych plików.
Kup książkę, aby przeczytać do końca.